Point clé
La sécurité des agents n'est pas un problème de modèle. Donnez à chaque agent sa propre identité, limitez les permissions par outil, traitez tout ce qu'il lit comme non fiable et appliquez les politiques en dehors du modèle, pour qu'un agent détourné ne puisse faire que des appels déjà encadrés.
La surface d’attaque d’un agent IA, c’est tout ce qu’il a le droit de lire, d’appeler et de modifier, pas le modèle lui-même. Ce guide s’adresse aux CTO, aux responsables de la sécurité et aux équipes d’ingénierie qui bâtissent des agents branchés sur de vrais systèmes. On y voit comment cartographier cette surface, cinq règles de conception pour l’identité et les permissions, une modélisation des menaces en une heure et la piste d’audit dont vous aurez besoin quand quelque chose tourne mal.
La plupart des revues de sécurité IA commencent par le modèle. Peut-on le débrider? Va-t-il divulguer sa requête système? Dira-t-il quelque chose d’offensant?
Ce sont de bonnes questions pour un robot conversationnel. Pour un agent, elles ratent l’essentiel du risque. Un agent lit des courriels, interroge des bases de données, appelle des API et écrit des enregistrements au nom de quelqu’un. Le modèle, c’est la partie qui décide. La surface d’attaque, c’est tout ce qu’il peut toucher.
Vu sous cet angle, le problème devient familier. C’est une identité avec des permissions, qui lit des entrées non fiables et pose des actions avec des effets réels. Les équipes de sécurité connaissent ce cas de figure. Ce qui est nouveau, c’est que cette identité prend ses instructions dans le texte qu’elle lit, et qu’elle choisit quelle permission utiliser au moment de l’exécution.
La sécurité des agents doit donc être pensée pendant le développement, par des gens qui comprennent les deux côtés. Une revue deux semaines avant le lancement peut trouver des problèmes. Elle peut rarement les corriger, parce que les corrections touchent l’architecture.
Quels sont les principaux risques de sécurité des agents IA?
Le détournement d’objectif, le mauvais usage des outils et l’abus de privilèges arrivent en tête. L’OWASP GenAI Security Project (Open Worldwide Application Security Project) a publié en décembre 2025 son Top 10 pour les applications agentiques, révisé par plus d’une centaine de praticiens, et ses trois premières entrées décrivent bien le changement :
- ASI01, détournement d’objectif de l’agent : des instructions cachées dans un document, un courriel ou une page Web réorientent ce que l’agent essaie de faire.
- ASI02, mauvais usage et exploitation des outils : l’agent utilise un outil qu’il a légitimement le droit d’utiliser, avec des paramètres nuisibles.
- ASI03, abus d’identité et de privilèges : des identifiants délégués et la confiance entre agents donnent un accès que l’agent ne devrait pas avoir.
Aucun des trois n’est un bogue du modèle. Chacun est une défaillance dans la façon dont l’identité, les permissions, les outils et les entrées non fiables s’emboîtent. La suite de l’article traite ces quatre éléments comme un seul système.
Comment cartographier la surface d’attaque d’un agent IA?
Une ligne par outil, avec sept colonnes qui couvrent ce qu’une équipe de sécurité doit analyser. On ne peut pas sécuriser un agent qu’on ne sait pas décrire, et la carte fait souvent ressortir des problèmes avant même qu’on modélise les menaces.
| Colonne | Question | Pourquoi c’est important |
|---|---|---|
| Outil | Que peut appeler l’agent? | L’unité de permission, pas l’agent dans son ensemble |
| S’exécute en tant que | Quelle identité exécute l’appel : celle de l’agent, de l’utilisateur ou un compte de service partagé? | Les comptes partagés effacent l’imputabilité |
| Lit | Quelles données reviennent, et d’où? | Chaque source externe est un canal d’instructions potentiel |
| Écrit / effets | Qu’est-ce qui change dans le monde quand il s’exécute? | Définit le rayon d’impact |
| Réversible? | Peut-on annuler le changement, et en combien de temps? | Les actions irréversibles exigent un point de contrôle |
| Contrôle | Que faut-il vérifier avant l’exécution : politique, approbation humaine, limite de débit? | Là où le contrôle se trouve vraiment |
| Trace | L’appel est-il consigné avec l’identité, les paramètres et le résultat? | Nécessaire pour réagir aux incidents |
Les équipes qui remplissent cette grille honnêtement font en général deux découvertes. L’agent a un accès en écriture qu’il n’utilise jamais, hérité d’une clé d’API trop large. Et au moins une source de lecture est contrôlée par des gens de l’extérieur : courriels entrants, portail fournisseur, lecteur partagé, page Web. C’est dans cette deuxième découverte que se cache le détournement d’objectif.
Comment concevoir l’identité et les permissions d’un agent IA?
Cinq règles. Donnez-lui sa propre identité, limitez les permissions par outil, méfiez-vous de tout ce qu’il lit, appliquez les politiques en dehors du modèle et gardez les secrets hors de la fenêtre de contexte.
1. Donner à l’agent sa propre identité
L’agent devrait s’authentifier en son propre nom : une identité non humaine, avec ses propres identifiants, visible dans votre fournisseur d’identité et vos journaux. Avec un compte de service partagé, chaque action se ressemble dans le journal d’audit. Avec le jeton de session complet d’un utilisateur, il peut faire tout ce que cet utilisateur peut faire, ce qui n’est presque jamais l’intention.
Quand l’agent agit pour un utilisateur, utilisez une délégation qui conserve les deux identités : cet agent, agissant pour cette personne, avec une portée plus étroite que celle de l’un ou l’autre. L’échange de jetons OAuth et les flux « au nom de » existent exactement pour ça. Des jetons de courte durée limitent le temps pendant lequel un identifiant divulgué reste utile.
2. Limiter les permissions par outil, pas par agent
L’erreur courante, c’est d’accorder à l’agent un seul ensemble de permissions qui couvre tout ce qu’il pourrait faire. Le moindre privilège pour les agents s’applique au niveau de l’outil. L’outil qui consulte une facture obtient un accès en lecture aux factures. L’outil qui planifie un paiement obtient une écriture étroitement limitée, et rien d’autre.
Séparez les chemins de lecture et d’écriture dans l’architecture même. Si le même identifiant peut lire la fiche d’un fournisseur et modifier ses coordonnées bancaires, une seule étape de raisonnement détournée peut faire les deux.
3. Traiter tout ce que l’agent lit comme non fiable
C’est la règle à laquelle les équipes résistent le plus, parce qu’elle dérange. Les documents récupérés, les résultats d’outils, le contenu des courriels et les pages Web peuvent contenir du texte qui ressemble à des instructions. Le modèle n’a aucun moyen fiable de distinguer votre requête système d’un paragraphe convaincant dans un PDF.
On ne peut pas régler ça complètement dans la requête. On le gère dans l’architecture. Gardez le contenu non fiable hors du contexte quand un outil à fort impact est disponible. Exigez une confirmation pour les actions déclenchées après la lecture de contenu externe. Ne laissez jamais le contenu d’un locataire ou d’un expéditeur autoriser une action pour un autre.
4. Appliquer les politiques en dehors du modèle
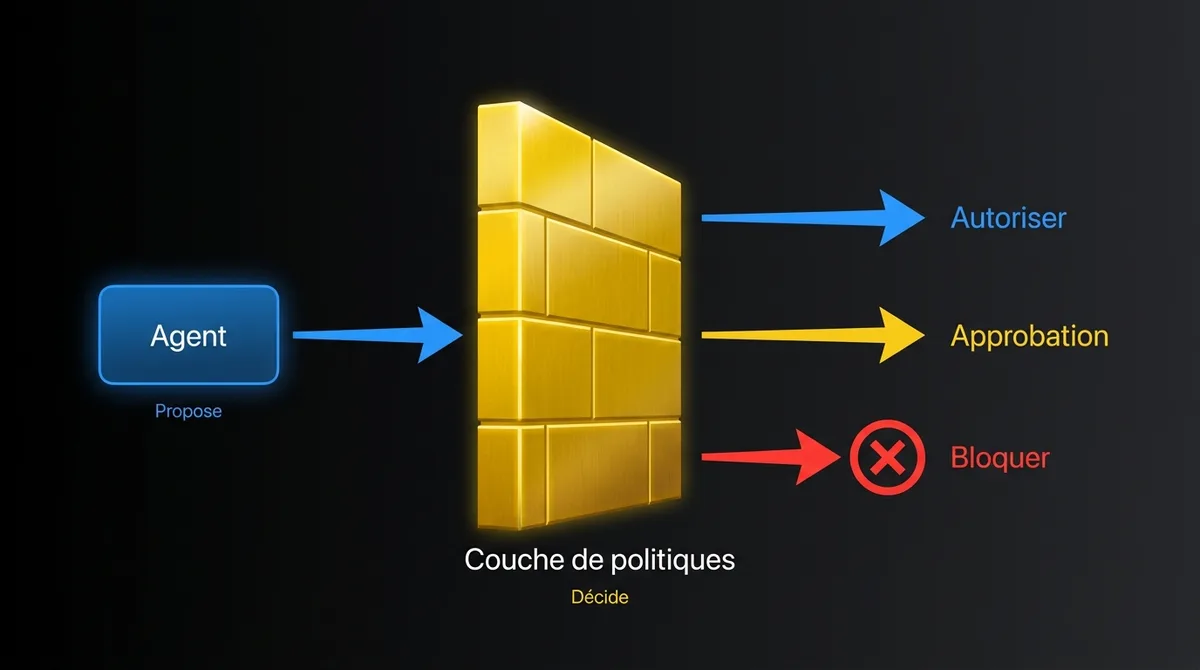
Placez un point d’application des politiques entre l’agent et ses outils. Chaque appel y passe. Il vérifie l’identité, la portée, les paramètres et les limites de débit selon des règles que le modèle ne peut ni voir ni modifier. « Les paiements au-delà d’un certain montant exigent une approbation. » « Cet outil ne peut modifier que les enregistrements de l’utilisateur qui fait la demande. » « Pas plus de cinq courriels sortants par tâche. »
Le modèle propose. La couche de politiques décide si l’appel s’exécute. C’est cette séparation qui rend le mauvais usage de type ASI02 contrôlable : même un agent complètement détourné ne peut faire que ce que la couche de politiques permet.
5. Garder les secrets hors de la fenêtre de contexte
Les clés d’API, les identifiants de base de données et les jetons ne devraient jamais apparaître dans les requêtes, les descriptions d’outils ou le contenu récupéré. L’agent appelle un outil par son nom. L’outil, qui s’exécute dans votre infrastructure, détient l’identifiant. Partez du principe que tout ce qui se trouve dans la fenêtre de contexte peut être répété par le modèle.
Pour la conception des outils eux-mêmes (granularité, gestion des erreurs, idempotence), voyez l’architecture des agents IA en production. Pour le volet données et interfaces du même problème, voyez les données prêtes pour les agents.
Comment modéliser les menaces d’un agent IA en une heure?
Passez chaque ligne de la carte au crible de quatre questions. Les méthodes formelles de modélisation des menaces fonctionnent pour les agents, mais la plupart des équipes ont besoin de quelque chose qu’elles peuvent terminer en une réunion.
| Question | Exemples de pistes |
|---|---|
| Qui peut mettre du texte devant cet agent? | Des employés? Des clients? N’importe qui pouvant envoyer un courriel ou modifier un fichier partagé? |
| Quel est le pire appel unique qu’il pourrait faire? | Quel outil, quels paramètres, sur quel enregistrement? |
| Qu’est-ce qui l’arrêterait? | Vérification de politique, approbation, limite de débit, rien? |
| Comment le saurait-on? | Y a-t-il une alerte, ou l’apprendrait-on par un client? |
La deuxième et la troisième questions comptent le plus. Si rien n’arrête le pire appel unique à part le jugement du modèle, c’est la première chose à corriger.
Les passations méritent leur propre examen. Quand un agent délègue à un autre, ou envoie du travail dans une file humaine, demandez-vous quelle identité la deuxième partie hérite et si le côté qui reçoit valide ce qu’on lui transmet. L’entrée ASI07 de la liste OWASP porte sur la communication non sécurisée entre agents, et on la manque facilement quand chaque agent a été révisé isolément.
Que doit consigner la piste d’audit d’un agent IA?
Assez d’information pour répondre à « pourquoi a-t-il fait ça? » après un incident. La traçabilité fait partie de la conception de sécurité, pas d’un exercice de conformité après coup. Au minimum, consignez pour chaque appel d’outil :
- L’identité de l’agent et, s’il y a lieu, l’utilisateur pour qui il agissait
- L’outil, les paramètres complets et la décision de la politique (autorisé, bloqué, envoyé en approbation)
- Le résultat, erreurs comprises
- Un identifiant de tâche ou de session qui relie l’appel à la demande qui l’a lancé, et au contenu externe présent dans le contexte à ce moment
Ce dernier élément permet à un enquêteur de retracer un détournement d’objectif. Sans lui, vous savez qu’une action a eu lieu, pas ce qui l’a déclenchée. Notre article sur l’observabilité des agents IA traite du volet opérationnel du traçage. Côté sécurité, la priorité est que l’agent ne puisse pas modifier ses traces et qu’elles soient conservées assez longtemps pour votre processus de réponse aux incidents.
À quoi ressemble la conception d’un agent sécurisé en pratique?
Voici un agent des comptes fournisseurs avant et après la cartographie de sa surface. C’est un exemple illustratif, pas un cas client.
L’agent : il lit les factures de fournisseurs reçues par courriel, les rapproche des bons de commande et met les paiements en file.
La première conception : un seul compte de service avec un accès en lecture et en écriture aux modules fournisseurs et paiements du PGI (progiciel de gestion intégré). L’agent lit la boîte de réception, extrait les données de facture et appelle l’API du PGI.
La carte révèle le problème. N’importe qui sur Internet peut écrire dans la boîte de réception. Le même identifiant qui lit les fiches fournisseurs peut modifier le compte bancaire d’un fournisseur. Un courriel disant « nos coordonnées bancaires ont changé, merci de les mettre à jour avant le traitement » est une fraude bien connue contre les commis aux comptes fournisseurs. Cette fois, elle vise un agent avec un accès en écriture.
La nouvelle conception :
- L’agent a sa propre identité, avec des outils distincts pour lire les factures, rapprocher les bons de commande et proposer des paiements.
- Aucun outil ne peut modifier les coordonnées bancaires d’un fournisseur. Ça reste un processus humain, avec vérification par un canal indépendant.
- Les propositions de paiement passent par une couche de politiques : plafonds de montant, vérification des fournisseurs connus et approbation au-delà d’un seuil.
- Chaque proposition est tracée avec l’identifiant du courriel source, pour qu’un réviseur voie ce que l’agent a lu avant d’agir.
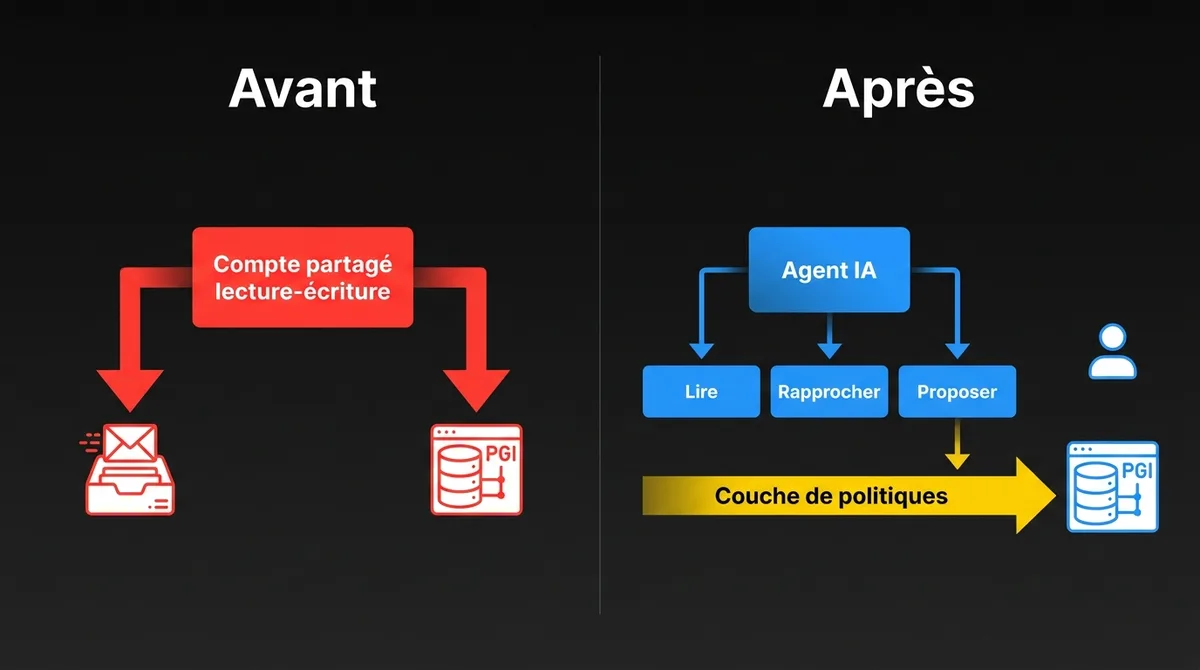
L’agent fait le même travail utile. Son pire appel unique est maintenant une proposition de paiement qu’une vérification de politique et, au-delà d’un seuil, une personne doivent approuver.
Quand faut-il intégrer la sécurité à un agent IA?
Dès la première séance de conception. Ce modèle ne coûte pas cher quand il est prévu dès le départ. L’ajouter après coup coûte cher, parce qu’il change des identités, des frontières d’outils et des flux de données dont le reste du système dépend déjà.
C’est pourquoi on traite la sécurité comme une partie de ce qu’on livre, pas comme un contrôle à la fin. Quand nos ingénieurs s’intègrent à l’équipe d’un client pour bâtir un agent, la carte de la surface et le modèle de menaces sont des livrables de départ, révisés avec vos ingénieurs en sécurité, dans votre code et votre cycle de mise en production. Le volet gouvernance du même travail se trouve dans notre guide sur la gouvernance de l’IA pour les équipes produit.
Questions fréquentes
Qu’est-ce que le détournement d’objectif d’un agent?
C’est quand des instructions cachées dans un contenu que l’agent lit, comme un courriel, un document ou une page Web, réorientent ce qu’il essaie de faire. L’OWASP le classe ASI01, le premier risque de son Top 10 pour les applications agentiques.
Un agent IA devrait-il utiliser un compte de service partagé?
Non. Un compte partagé rend toutes les actions identiques dans le journal d’audit et accorde en général bien plus d’accès que l’agent n’en a besoin. Donnez-lui sa propre identité non humaine, et utilisez des jetons délégués de courte durée quand il agit pour un utilisateur précis.
L’ingénierie de requêtes peut-elle bloquer l’injection de requêtes dans un agent IA?
Pas de façon fiable. Le modèle ne distingue pas toujours vos instructions d’un texte convaincant dans un document, alors la protection doit se trouver dans l’architecture : permissions par outil, couche de politiques en dehors du modèle et confirmation pour les actions à fort impact déclenchées par du contenu externe.
Quel est le pire appel que votre agent pourrait faire aujourd’hui?
Choisissez un agent que vous planifiez ou qui roule déjà. Cartographiez ses permissions les plus risquées et ses passations. Si rien n’arrête son pire appel unique à part le jugement du modèle, vous avez trouvé votre première correction.
On offre des revues de surface d’attaque d’agents de 30 minutes. Apportez un agent prévu : on cartographie ses outils, ses identités et ses passations avec votre équipe, puis on repère les permissions à retirer ou à encadrer en premier. Réservez une revue.