Point clé
Un agent IA n'est fiable que si les données et les interfaces sur lesquelles il agit le sont. Avant de lui donner un accès en écriture, évaluez le cas d'usage sur quatre couches (définitions, interfaces, contrôles et observabilité), et sous 10 sur 20, consolidez les fondations au lieu d'acheter un plus gros modèle.
Les agents IA agissent sur vos données, alors chaque faiblesse dans ces données devient une action. Cet article s’adresse aux CDO (chefs des données) et aux CTO qui s’apprêtent à donner à un agent un accès en écriture à de vrais systèmes. On y présente une revue des fondations à faire sur un cas d’usage : définitions, interfaces, contrôles et observabilité, notés sur 20.
Un tableau de bord bâti sur une mauvaise définition donne un graphique erroné. Quelqu’un plisse les yeux en réunion, pose une question, et le chiffre est corrigé.
Un agent bâti sur la même mauvaise définition envoie le mauvais crédit à un client. Puis il recommence 400 fois avant que quelqu’un s’en rende compte, parce que personne ne plissait les yeux. On faisait confiance à l’agent pour agir.
C’est le changement que les agents apportent au travail sur les données. L’analytique tolère l’ambiguïté parce qu’une personne se trouve entre les données et la décision. Les agents retirent cette personne, ou du moins l’éloignent. Chaque faiblesse qu’un humain absorbait se transforme directement en action : une définition floue, une API aux effets secondaires non documentés, un compte de service avec trop d’accès, un pipeline devenu périmé sans que personne le remarque.
Les recherches de McKinsey d’avril 2026 sur la mise à l’échelle de l’IA agentique chiffrent l’écart. Près des deux tiers des grandes entreprises ont fait des essais avec des agents, et moins d’une sur dix les a déployés à grande échelle avec une valeur concrète. Huit sur dix citent les limites de leurs données comme obstacle. Notre expérience va dans le même sens, avec une nuance. Le problème vient rarement des données seules. Il vient des données et des interfaces qui les entourent.
Des données fiables sont-elles prêtes pour un agent?
Non. Des données fiables suffisent à une personne qui en connaît les particularités. Des données prêtes pour un agent doivent être sûres pour un système sans contexte, sans jugement sur les exceptions et sans peur d’être congédié.
Dans Des données à la valeur, on recommandait de commencer par une décision et une source à laquelle son responsable fait déjà confiance. C’est toujours la bonne première étape. Pour un agent, ça ne suffit pas.
Une personne qui fait confiance à une source sait aussi où elle plie. Elle sait que le champ « région » est vide pour les comptes migrés en 2023. Elle sait que l’API de remboursement met une minute à refléter un changement. Elle sait qu’il ne faut pas toucher aux comptes entreprise sans demander au gestionnaire du compte. Rien de tout ça n’est écrit, alors l’agent n’en sait rien.
Quatre couches déterminent si un agent peut agir sur les données en toute sécurité.
| Couche | La question | Ce qui casse quand elle manque |
|---|---|---|
| Définitions | Le sens d’affaires de chaque champ utilisé par l’agent est-il écrit, dans une forme lisible par une machine? | L’agent choisit un des trois sens de « client actif » et agit en conséquence |
| Interfaces | L’agent accède-t-il aux systèmes par des API stables, documentées et versionnées? | Les écrans moissonnés cassent, du SQL brut frappe la production, les relances dupliquent les écritures |
| Contrôles | L’accès de l’agent est-il limité à la tâche, avec des plafonds et un circuit d’approbation? | Un compte de service administrateur partagé permet à une injection de requête de faire de vrais dégâts |
| Observabilité | Voyez-vous la qualité des données avant que l’agent agisse, et pouvez-vous reconstituer chaque action après? | Des données périmées mènent à des actions fausses mais assurées, et personne ne peut expliquer pourquoi |
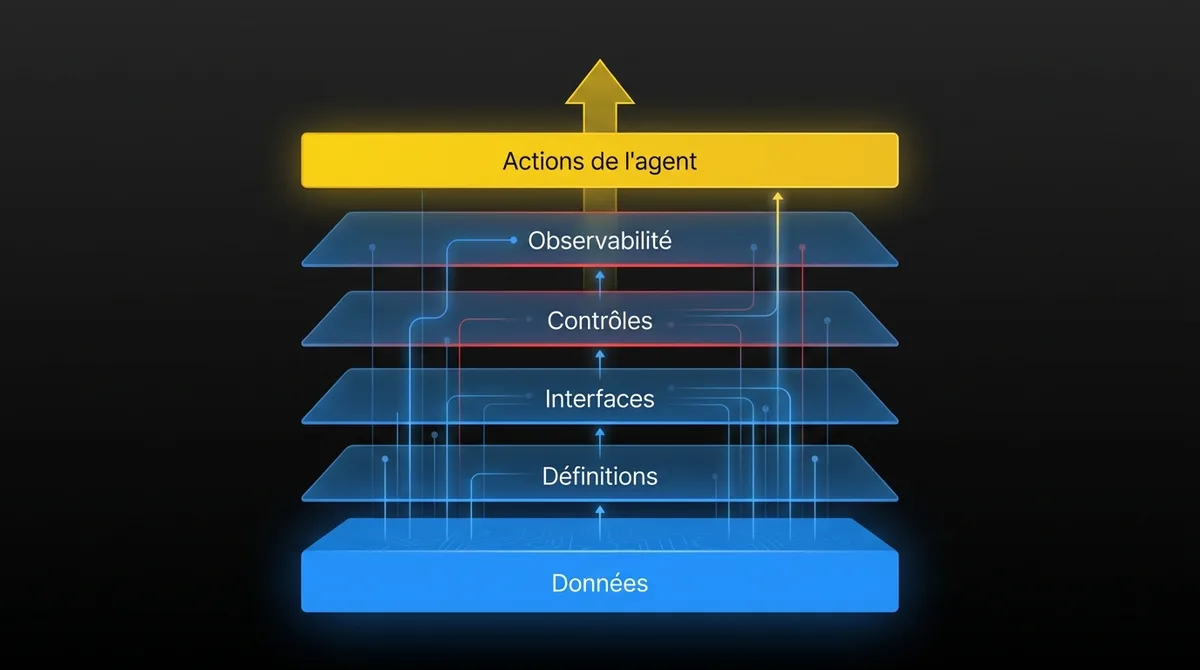
Les principes d’architecture de McKinsey vont dans le même sens. Deux d’entre eux portent sur le partage du sens avec les données et l’exposition des capacités par des interfaces stables. Les deux sont escamotés dans la plupart des projets pilotes, parce que le pilote roule sur un extrait propre avec un développeur qui surveille.
Comment écrire des définitions de données qu’un agent IA peut utiliser?
Rendez chacune explicite, unique pour le cas d’usage et accessible au moment de l’exécution. La plupart des organisations ont déjà des définitions. Elles vivent dans la couche de métriques d’un outil BI, une page wiki de 2022 et la tête de trois analystes d’expérience, et elles se contredisent.
Écrivez les termes sur lesquels l’agent raisonne. Pas tout le glossaire. Pour un agent de facturation : client, abonnement actif, statut de facture, litige, crédit et admissible. Chacun a une définition, un responsable et le champ source auquel il correspond.
Placez les définitions là où l’agent peut les récupérer. Une couche sémantique ou un magasin de métriques est l’endroit le plus propre. Un document bien structuré dans le contexte de récupération de l’agent fonctionne aussi pour un premier cas d’usage. Une page wiki vers laquelle personne ne pointe, non.
Codez les exceptions. Les règles qu’une personne garde en tête (« ne jamais créditer automatiquement un compte en recouvrement ») sont aussi des définitions. Si elles comptent, elles vont dans le code ou dans une politique que l’agent vérifie. Une instruction dans la requête n’est pas le bon endroit, puisque le modèle peut la mettre en balance avec d’autres instructions.
Vérification : choisissez cinq termes que l’agent utilise. Demandez à deux personnes de deux équipes différentes de les définir. Si les réponses diffèrent, l’agent se trompera pour une de ces équipes.
Qu’est-ce qui rend une API sûre pour un agent IA?
Un contrat. Les agents appellent des outils, et chaque outil est une interface vers un vrai système. La plupart de ces interfaces ont été bâties pour des gens qui cliquent sur des boutons ou pour des traitements par lots, pas pour un appelant automatisé qui relance en cas d’échec et lit les messages d’erreur au pied de la lettre.
Une interface prête pour un agent a cinq propriétés.
- Versionnée et documentée. La définition d’outil de l’agent pointe vers une version précise de l’API, avec un schéma. Quand l’API change, la définition d’outil change avec elle, par revue de code.
- Entrées et sorties typées. Des énumérations plutôt que du texte libre quand c’est possible. Un montant de crédit est un décimal avec une devise et un plafond, pas une chaîne de caractères.
- Écritures idempotentes. Chaque écriture prend une clé d’idempotence, un identifiant unique qui rend un appel répété sans effet. Si l’agent relance après un délai d’attente, le client reçoit un crédit, pas deux.
- Des erreurs qui s’expliquent. « Compte en recouvrement; les crédits exigent une approbation » permet à l’agent d’acheminer correctement. « 400 Bad Request » mène à une boucle de relances.
- Des opérations au niveau d’affaires. Exposez « émettre un crédit de courtoisie » comme une seule opération qui applique ses propres règles. Ne laissez pas l’agent composer trois appels de bas niveau sur le grand livre.
Le dernier point compte le plus. Plus il y a de logique d’affaires derrière l’interface, moins l’agent doit réussir seul. On approfondit la conception d’outils dans l’architecture des agents IA en production.
Vérification : dressez la liste de chaque outil que l’agent appelle. Pour chacun, pouvez-vous montrer son schéma, sa version et ce qui se passe quand on l’appelle deux fois avec la même entrée?
Quelles permissions un agent IA devrait-il avoir?
Le moins possible pour faire la tâche, accordées par opération, avec des limites strictes appliquées en dehors de la requête. La façon la plus rapide de faire marcher une démo, c’est de donner à l’agent les identifiants qu’un développeur a déjà. C’est aussi comme ça qu’on se retrouve avec un agent capable de supprimer des enregistrements qu’il devrait seulement lire.
L’agent a sa propre identité. Pas un compte de service partagé ni le jeton d’une personne. Son propre principal, pour que chaque action lui soit attribuable et que son accès puisse être révoqué sans rien briser d’autre.
Lecture seule par défaut. L’accès en écriture s’accorde par opération, pas par système. « Peut émettre des crédits » est une permission. « A un accès en écriture à la facturation » n’en est pas une.
Des limites sur chaque écriture. Des plafonds par action (aucun crédit au-delà d’un montant fixé), des limites de débit (pas plus d’un certain nombre d’actions par heure) et des limites de portée (seulement les comptes d’un segment donné). Appliquez-les dans l’interface, pas dans la requête.
Un circuit d’approbation au-delà de la limite. L’agent prépare l’action et une personne l’approuve. Le flux continue au lieu d’échouer, et vous obtenez un registre étiqueté des recommandations qu’un humain a acceptées.
Des entrées traitées comme non fiables. Si l’agent lit des courriels de clients, des billets de soutien ou des documents, quelqu’un peut y glisser des instructions. Des permissions limitées empêchent une injection de requête réussie de devenir un incident grave. Notre guide sur la surface d’attaque des agents IA traite le sujet en profondeur.
Vérification : si l’agent suivait une instruction malveillante cachée dans un billet de soutien, quelle est la pire action unique qu’il pourrait poser? Si la réponse vous met mal à l’aise, les permissions sont trop larges.
Que faut-il surveiller avant et après l’action d’un agent IA?
Les données qui entrent et un registre de ce qui sort. L’observabilité des agents veut généralement dire tracer l’agent lui-même : requêtes, appels d’outils, latence, coût. C’est nécessaire, et on en parle dans l’observabilité des agents IA. La moitié qu’on oublie, c’est de surveiller les données sur lesquelles l’agent s’apprête à agir.
Avant l’action : des contrôles de qualité des données. Fraîcheur (quand cette source a-t-elle été mise à jour?), complétude (les champs requis sont-ils remplis pour cet enregistrement?), schéma (une colonne a-t-elle changé de type en amont?) et volume (le chargement d’aujourd’hui a-t-il baissé de moitié?). Si un contrôle échoue, l’agent s’arrête ou envoie le cas à une personne. Il ne fonce pas sur des données périmées.
Après l’action : un registre de décision. Ce que l’agent a vu, quelles définitions et politiques il a appliquées, quel outil il a appelé avec quels arguments, ce que le système a répondu et ce qui a changé. Conservez-le là où l’entreprise peut l’interroger, pas seulement dans un outil de traçage d’ingénierie.
Vérification : choisissez une action que l’agent a posée la semaine dernière. Une personne qui n’est pas ingénieure peut-elle trouver, en moins de dix minutes, quelles données il a utilisées et pourquoi il a agi?
Comment évaluer si un cas d’usage est prêt pour un agent?
Notez dix items à 0 (absent), 1 (partiel) ou 2 (en place), pour un cas d’usage précis plutôt que pour toute l’entreprise. Le total sur 20 indique s’il faut déployer avec accès en écriture, déployer en mode recommandation seulement ou consolider les fondations d’abord.
| # | Item | 0 / 1 / 2 |
|---|---|---|
| D1 | Chaque terme sur lequel l’agent raisonne a une définition écrite et un responsable | |
| D2 | Les définitions et les exceptions d’affaires sont accessibles à l’exécution | |
| I1 | Chaque outil correspond à une API versionnée et documentée | |
| I2 | Toutes les opérations d’écriture sont idempotentes | |
| I3 | Les erreurs sont assez descriptives pour que l’agent achemine correctement | |
| C1 | L’agent a sa propre identité, en lecture seule par défaut | |
| C2 | Les permissions d’écriture sont accordées par opération, avec plafonds et limites de débit appliqués dans l’interface | |
| C3 | Les actions au-delà des limites vont à un approbateur humain | |
| O1 | Des contrôles de fraîcheur, de complétude et de schéma conditionnent les actions de l’agent | |
| O2 | Chaque action produit un registre de décision que l’entreprise peut interroger |
Comment lire le total :
- 16 à 20 : prêt pour un déploiement supervisé avec accès en écriture dans un segment limité.
- 10 à 15 : déployez en mode recommandation seulement pendant qu’on comble les lacunes. L’agent rédige, une personne exécute.
- Moins de 10 : consolidez d’abord les fondations. Le chemin le plus court vers un agent qui fonctionne, c’est deux ou trois jalons de fondation, pas un plus gros modèle.
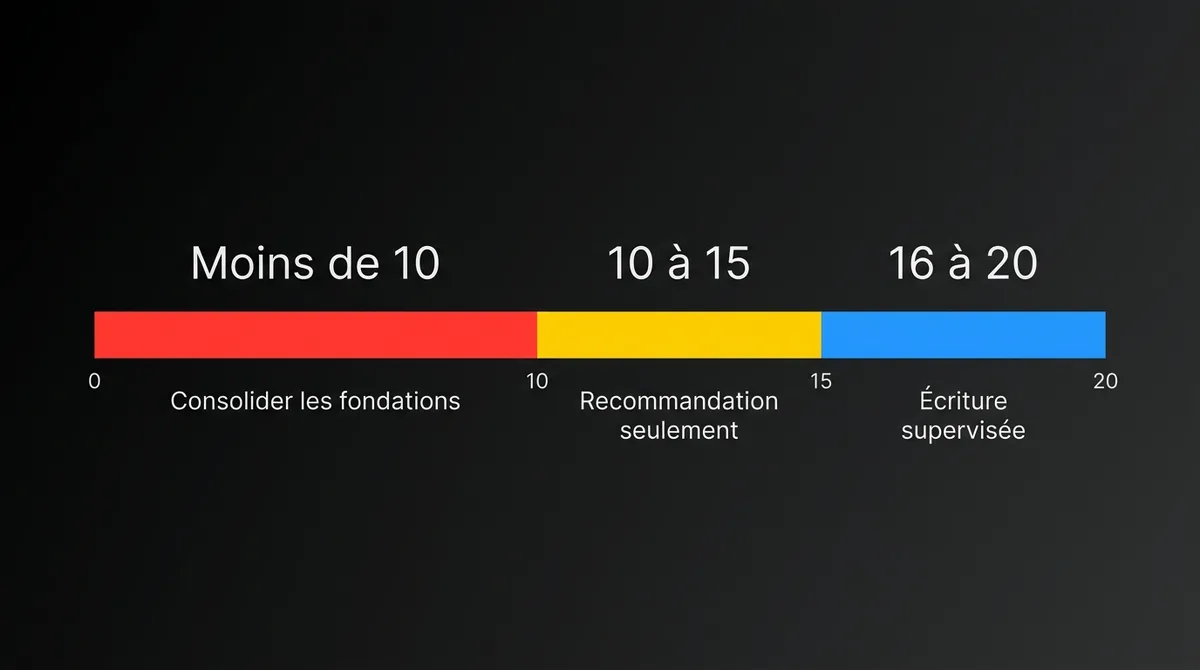
Un score faible sur un premier cas d’usage est normal, et c’est utile. Les zéros vous disent quelles deux ou trois corrections viennent en premier.
À quoi ressemble une revue des fondations sur un vrai agent?
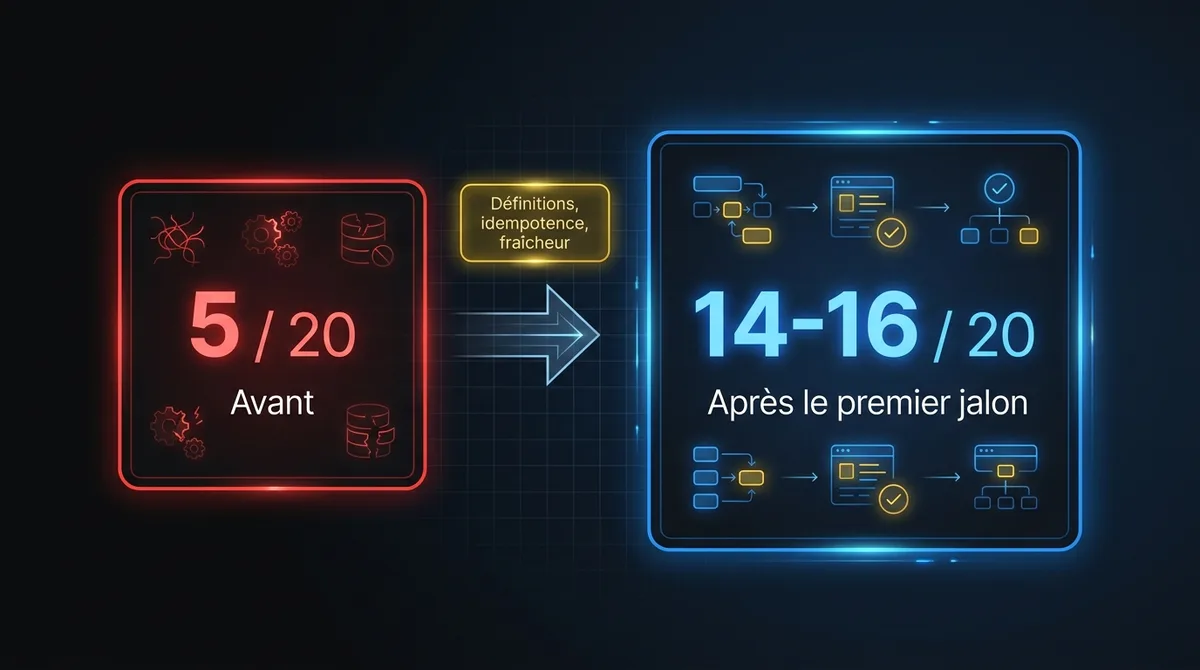
Voici un agent de litiges de facturation qui fonctionnait en pilote et qui a obtenu 5 sur 20. L’exemple est illustratif. La structure est typique; l’entreprise et les chiffres ne sont pas réels.
Le cas d’usage. Une entreprise SaaS B2B veut un agent pour traiter les litiges de facturation : lire le message du client, vérifier la facture et l’utilisation, puis émettre un crédit de courtoisie quand le litige est valide.
Le pilote. Il a bien fonctionné sur 50 billets choisis à la main. Lors d’un essai en parallèle sur des billets réels, il aurait crédité trois comptes en recouvrement et crédité deux fois un client après un délai d’attente.
La grille.
- D1 : 0. « Litige valide » n’avait aucune définition écrite. Les finances et le soutien ne s’entendaient pas sur les dépassements d’utilisation.
- D2 : 0. L’exception pour les comptes en recouvrement n’existait que dans la tête d’un gestionnaire.
- I1 : 1. Les factures avaient une API documentée; les données d’utilisation venaient d’une requête brute dans l’entrepôt.
- I2 : 0. Le point de terminaison des crédits n’était pas idempotent.
- I3 : 1. Partiel.
- C1 : 1. L’agent avait sa propre identité, mais avec un large accès en écriture à la facturation.
- C2 : 0. Aucun plafond.
- C3 : 1. Une file d’approbation existait pour les remboursements, pas pour les crédits.
- O1 : 0. Les données d’utilisation avaient parfois 36 heures de retard, sans signalement.
- O2 : 1. Les traces n’existaient que dans l’outil d’ingénierie.
Total : 5 sur 20. Le modèle n’a jamais été le problème.
Le premier jalon. Les finances et le soutien s’entendent sur une définition écrite de « litige valide » et sur l’exception des comptes en recouvrement. L’ingénierie encapsule les crédits dans une opération d’affaires « émettre un crédit de courtoisie » avec une clé d’idempotence, un plafond par crédit et un envoi automatique en approbation pour les comptes en recouvrement. Un contrôle de fraîcheur arrête l’agent quand les données d’utilisation ont plus de six heures. L’agent est déployé en mode recommandation seulement pour un segment. Réévalué après le jalon, le cas d’usage se situe entre 14 et 16, et l’équipe a un chemin clair vers l’écriture supervisée.
Sur un agent en production. On a fait les mêmes choix pour un agent IA pour créateurs mis entre les mains de vrais utilisateurs en moins de trois semaines. L’agent agit en tant qu’utilisateur connecté, à travers les mêmes règles de sécurité au niveau des lignes (Row Level Security) de Postgres que l’interface, et il n’existe aucune clé de service qu’il pourrait détourner. Il dispose de 17 actions typées aux entrées validées et ne peut rien faire en dehors de cette liste. Il peut archiver mais jamais supprimer, donc chacune de ses modifications peut être annulée. Les interfaces et les contrôles étaient réglés avant que le premier utilisateur y touche.
Qui devrait mener une revue des fondations pour un agent?
L’équipe de données, les ingénieurs applicatifs, la sécurité et le responsable d’affaires, ensemble. Le travail traverse des groupes qui ne se retrouvent pas souvent dans la même pièce. Les données s’occupent des définitions et des contrôles de qualité. Les ingénieurs plateforme ou applicatifs s’occupent des API. La sécurité s’occupe de l’identité et des permissions. L’entreprise s’occupe des exceptions.
Les agents forcent ces groupes à se parler, ce qui est utile en soi. Ce qui manque souvent, c’est quelqu’un qui a déjà livré des agents en production et qui peut faire le pont, quelqu’un qui sait quelles lacunes bloquent un agent et lesquelles paraissent seulement mal sur une diapositive.
C’est le rôle que jouent nos ingénieurs. Ils s’intègrent à votre équipe, font la revue des fondations sur un cas d’usage, puis travaillent dans votre code pour combler les principales lacunes et livrer l’agent qui repose dessus, dans votre cycle de mise en production. Les définitions, interfaces et contrôles restent à votre équipe à la fin du mandat, prêts pour le prochain agent. Pour voir comment le travail intégré se déroule d’une semaine à l’autre, consultez le développement augmenté par l’IA.
Questions fréquentes
Que veut dire « données prêtes pour un agent »?
Ça veut dire qu’un agent IA peut agir sur les données en toute sécurité sans qu’un humain fournisse le contexte. Les termes ont une définition écrite, les systèmes sont accessibles par des API versionnées avec des écritures idempotentes, l’accès est limité par opération, et des contrôles de qualité s’exécutent avant chaque action.
Un agent IA peut-il utiliser nos API existantes?
Souvent, mais rarement telles quelles. La plupart des API internes ont été bâties pour des personnes ou des traitements par lots. Elles ont besoin d’entrées typées, de clés d’idempotence, d’erreurs descriptives et d’opérations au niveau d’affaires avant qu’un agent y écrive.
Un agent IA devrait-il commencer avec un accès en écriture?
Pas à moins que le cas d’usage obtienne 16 sur 20 ou plus à la revue des fondations. En dessous, faites-le fonctionner en mode recommandation seulement : il rédige les actions et une personne les approuve pendant que vous comblez les lacunes.
À quelle source de données ne feriez-vous pas confiance pour un agent?
Chaque entreprise en a une. Le système que tout le monde contourne, la table avec la colonne peu fiable, l’API dont personne ne veut voir un appelant automatisé s’approcher. Commencez par là.
Dites-nous laquelle, et on fera une revue des fondations sur un cas d’usage : données, interfaces, contrôles et observabilité, notés avec la grille ci-dessus. Vous repartez avec les lacunes en ordre de priorité et un premier jalon proposé. Réservez une revue des fondations.