Point clé
La souveraineté des données en IA est une décision d'architecture, pas un obstacle de conformité. Classez les charges de travail selon leur exposition, comparez deux ou trois modèles d'hébergement sur la résidence, la juridiction et la portabilité, prévoyez la sortie avant de signer et faites signer la position par un dirigeant imputable.
Cet article s’adresse aux DSI, aux CISO et aux CTO d’entreprises canadiennes réglementées dont les projets d’IA restent coincés en revue de risque. Il explique comment classer les charges de travail selon leur exposition, comparer équitablement les modèles d’hébergement, prévoir la sortie dès le premier jour et mener une revue d’architecture en cinq questions pour chaque charge de travail. Il décrit des lois publiques et des engagements de fournisseurs à titre informatif. Ce n’est pas un avis juridique, et c’est à vos conseillers juridiques d’arrêter la position finale.
Dans les entreprises canadiennes réglementées, les projets d’IA meurent rarement pendant le projet pilote. Ils meurent juste après.
La preuve de concept fonctionne. Puis le CISO (chef de la sécurité de l’information) demande où vont les données des clients pendant l’inférence. Les juristes demandent quels gouvernements pourraient en exiger l’accès. L’approvisionnement demande ce que l’entreprise possède si elle quitte le fournisseur dans deux ans. Personne n’a de réponse documentée, alors le projet part en revue de risque sans responsable ni échéance.
À notre avis, c’est un problème d’architecture déguisé en problème de conformité. La résidence, l’exposition juridique et la portabilité sont des décisions de conception. Prises tôt, une charge de travail à la fois, on peut les écrire, les comparer et les faire approuver. Prises tard, elles deviennent une raison d’arrêter.
Pourquoi l’hébergement au Canada ne règle-t-il pas la question de la souveraineté des données en IA?
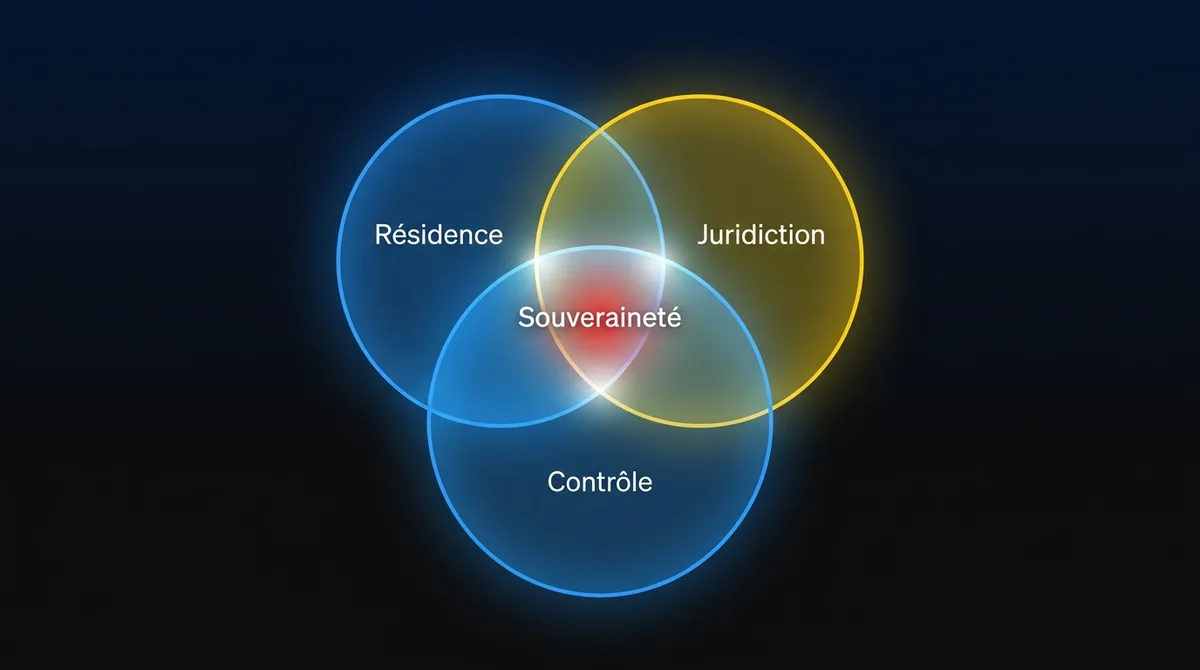
Parce que la souveraineté a trois volets, et que la résidence n’en est qu’un. La juridiction et le contrôle comptent autant, et une charge de travail peut bien s’en tirer sur la résidence tout en échouant sur les deux autres.
Les options d’hébergement au Canada se sont beaucoup améliorées. AWS a des régions à Montréal et à Calgary. Microsoft a des régions Azure à Toronto et à Québec, et en décembre 2025 l’entreprise s’est engagée à « garder les données canadiennes en sol canadien », avec le traitement au pays des interactions Copilot, une offre Azure Local élargie pour les environnements détenus par les clients et une Sovereign AI Landing Zone pour le Canada prévue en 2026. En octobre 2025, ThinkOn, Hypertec, Aptum et eStruxture ont annoncé ce qu’ils présentent comme le premier nuage gouvernemental canadien souverain de bout en bout, prêt pour l’IA.
Pour bien des charges de travail, ça règle la question. Pour celles qui sont réglementées, regardez les trois volets.
La résidence. L’endroit où les données se trouvent physiquement et où elles sont traitées. Ça comprend les prompts, le contexte récupéré, les résultats du modèle, les journaux et la télémétrie. Les équipes vérifient souvent la région de la base de données et oublient que l’appel d’inférence, l’index vectoriel ou l’outil d’observabilité tourne ailleurs.
La juridiction. Les gouvernements qui peuvent légalement exiger l’accès. Le CLOUD Act américain permet aux autorités des États-Unis d’obliger les fournisseurs américains à produire les données qu’ils ont en leur possession, sous leur garde ou sous leur contrôle, peu importe où elles sont stockées. L’engagement canadien de Microsoft le reconnaît franchement : l’entreprise promet de contester les demandes gouvernementales visant les données de ses clients « lorsque nous avons un fondement juridique pour le faire ». C’est un engagement sérieux. Il reste conditionnel.
Le contrôle. Ce que vous pouvez emporter avec vous. Vos données, oui, mais aussi les prompts, les jeux d’évaluation, la logique de récupération, les poids ajustés et le code d’intégration qui font fonctionner le système. C’est votre propriété intellectuelle. Si elle n’existe que dans le service géré d’un fournisseur, vous ne la contrôlez pas entièrement.
Quelles règles canadiennes de protection de la vie privée s’appliquent aux charges de travail IA?
Deux cadres reviennent dans presque toutes les revues : la LPRPDE (Loi sur la protection des renseignements personnels et les documents électroniques) au fédéral, et la Loi 25 au Québec. On les interprète souvent de travers, dans des sens opposés. La LPRPDE est plus souple sur les transferts qu’on le pense, et la Loi 25 est plus stricte.
La LPRPDE n’exige pas que les données restent au Canada. Elle vous rend toutefois responsable des renseignements personnels que vous transférez à un sous-traitant, y compris à l’étranger. Les lignes directrices du Commissariat à la protection de la vie privée du Canada sur le traitement transfrontalier demandent aux organisations d’assurer, par contrat ou autrement, un niveau de protection comparable, et d’être transparentes envers les personnes concernées. Le Commissariat révise ces lignes directrices depuis 2019, alors vérifiez la position actuelle avec vos juristes.
La Loi 25 du Québec est plus stricte sur les transferts. Depuis septembre 2023, une organisation doit réaliser une évaluation des facteurs relatifs à la vie privée (EFVP) avant de communiquer à l’extérieur du Québec des renseignements personnels recueillis au Québec. Ça inclut les autres provinces canadiennes, et ça s’applique quand vous confiez à un tiers hors Québec le stockage ou le traitement des données. Une API de modèle hébergée hors Québec est ce genre de tiers. L’évaluation n’interdit pas le transfert. Elle vous oblige à démontrer que les renseignements seront adéquatement protégés.
La politique fédérale bouge aussi. La Stratégie canadienne sur la capacité de calcul souveraine pour l’IA a été lancée en décembre 2024. Les demandes au Programme d’infrastructure de calcul souverain pour l’IA, qui vise à bâtir un superordinateur d’IA détenu par des intérêts canadiens, ont ouvert en avril 2026. La stratégie nationale en IA annoncée en juin 2026, « AI for All », fait de « jeter les bases d’une IA souveraine canadienne » l’un de ses six piliers et s’engage à moderniser les lois sur la vie privée. La majeure partie de cette capacité vise la recherche et l’industrie, pas votre prochain déploiement. Elle indique tout de même aux conseils d’administration vers où vont les attentes.
Comment savoir quelles charges de travail IA ont besoin d’une revue de souveraineté?
Classez-les en trois paliers selon leur exposition. La plupart n’ont pas besoin de revue de souveraineté, et la façon la plus rapide de débloquer un programme est de séparer les quelques-unes qui en ont besoin de toutes les autres.
| Palier | Ce qu’on y trouve | Exemples typiques | Posture par défaut |
|---|---|---|---|
| 1. Faible exposition | Données publiques ou non personnelles, aucun contenu réglementé, aucune propriété intellectuelle clé | Ébauches de textes marketing, recherche dans des documents publics, assistants de code internes sur des dépôts non sensibles | N’importe quel fournisseur et région de bonne réputation. Revue standard du fournisseur. |
| 2. Données personnelles ou contractuelles | Renseignements personnels, données clients sous contrat, données recueillies au Québec | Résumés pour le service à la clientèle, triage de réclamations, traitement de documents RH | Résidence canadienne pour les données et l’inférence. EFVP selon la Loi 25 quand des données du Québec sont en jeu. Contrats de sous-traitance documentés. |
| 3. Conséquences élevées | Dossiers réglementés, données gouvernementales ou liées à la défense, données visées par des clauses contractuelles explicites de résidence ou de juridiction, propriété intellectuelle névralgique | Dossiers de santé, stratégies de négociation, données de fournisseurs du secteur public, modèles exclusifs | Position explicite sur la juridiction, signée par un dirigeant imputable. Envisager une infrastructure contrôlée par le client ou détenue par des intérêts canadiens. |
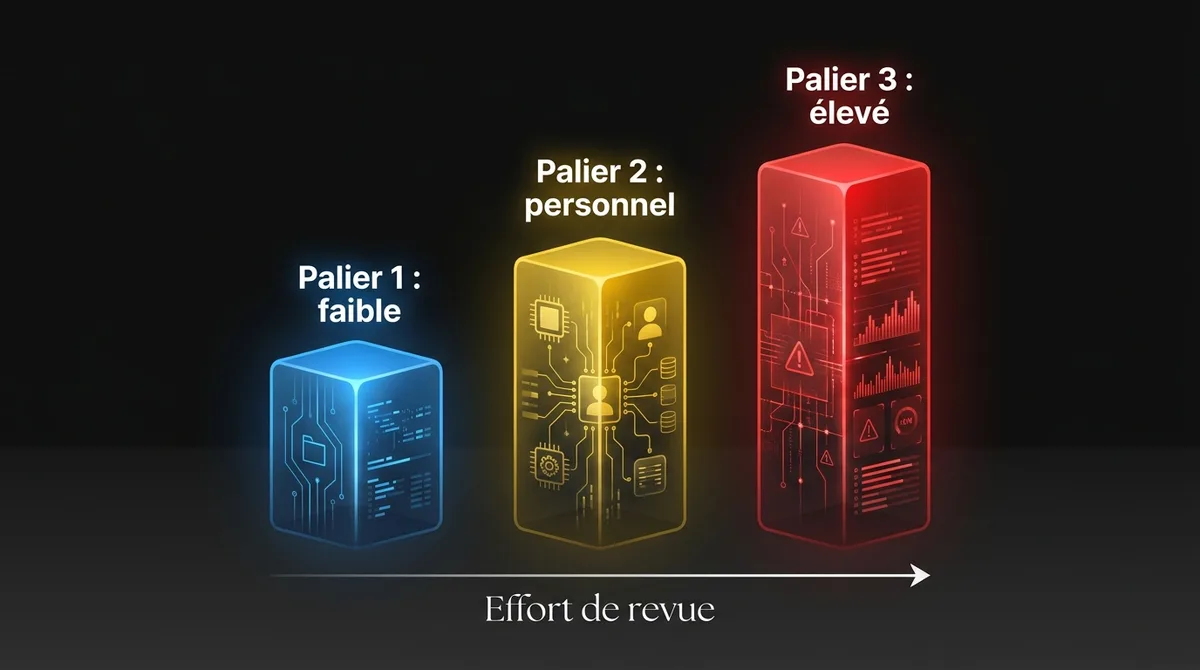
Le palier 1 devrait avancer cette semaine. Le palier 2 avance généralement dès que quelqu’un documente le flux de données. C’est au palier 3 que la revue d’architecture fait toute la différence.
Quel modèle d’hébergement choisir pour une charge de travail IA réglementée au Canada?
Pour une charge de travail de palier 2 ou 3, comparez côte à côte deux ou trois modèles réalistes. Chacun a de vraies forces. Le but est un choix défendable, pas un gagnant.
| Modèle | Résidence | Exposition juridictionnelle | Portabilité | Capacités et rapidité | À surveiller |
|---|---|---|---|---|---|
| A. Région canadienne d’un hyperscaler, services d’IA gérés | Forte si chaque composant est fixé dans la région | Société mère américaine soumise au CLOUD Act; engagements du fournisseur à contester les demandes | Dépend de l’usage de services exclusifs | La plus élevée. Le plus grand choix de modèles et d’outils. | Journaux, télémétrie et points de terminaison de modèles qui se rabattent par défaut sur d’autres régions |
| B. Pile d’un hyperscaler dans un environnement détenu par le client | Forte | Accès opérationnel réduit, mais logiciel et soutien viennent encore d’un fournisseur américain | Modérée | Élevée, avec quelques services manquants | Parité des fonctionnalités et charge d’exploitation |
| C. Fournisseur infonuagique détenu par des intérêts canadiens | Forte | Juridiction canadienne pour le fournisseur; vérifier les sous-traitants | Modérée à élevée | Catalogue d’IA gérée plus restreint; souvent jumelé à des modèles à poids ouverts | Capacité GPU, profondeur du soutien, maturité des services |
| D. Sur site ou en colocation avec des modèles à poids ouverts | Totale | Exposition externe la plus faible | La plus élevée | Plus faible; vous exploitez tout | Coûts d’exploitation, personnel, écart de qualité des modèles pour certaines tâches |
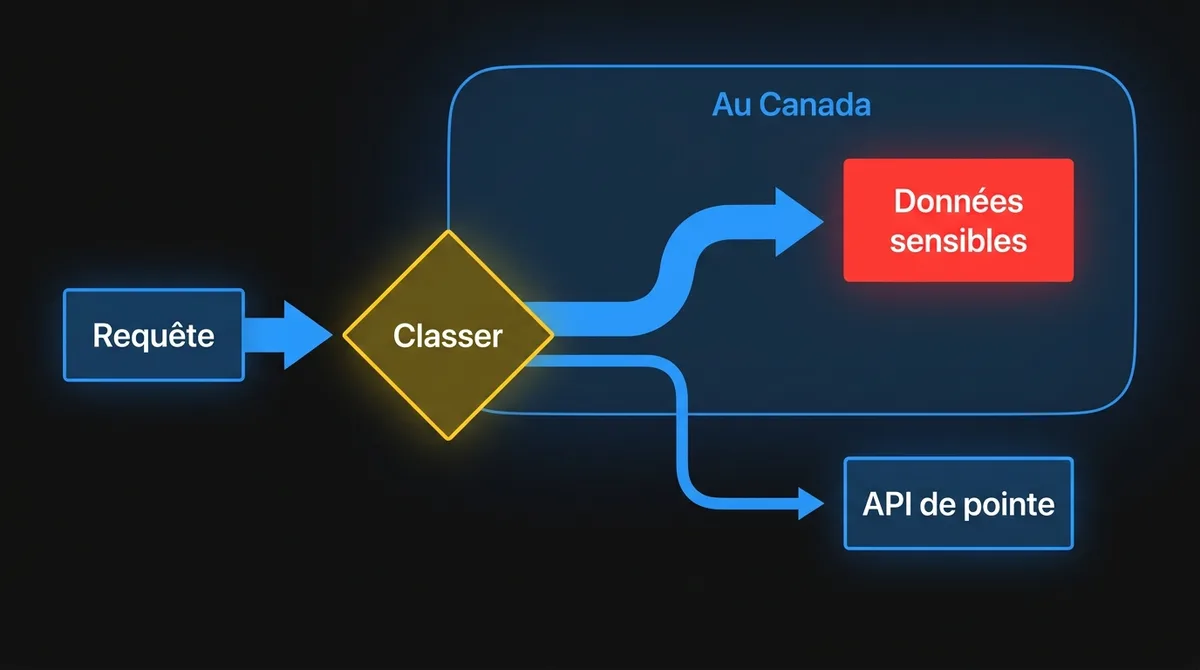
| E. Partage hybride | Données sensibles et inférence dans A à D; tâches non sensibles sur des API de modèles de pointe | Concentrée là où ça compte | Élevée si la séparation est nette | Élevées dans l’ensemble | La logique d’acheminement doit être appliquée dans le code, pas dans une politique |
Le modèle E est celui qu’on recommande le plus souvent, parce qu’il empêche la charge de travail la plus sensible de dicter les règles d’hébergement de tout le reste. Une étape de caviardage ou de classification décide quelles requêtes peuvent sortir du périmètre, et cette décision est journalisée.
Les clés de chiffrement gérées par le client reviennent dans chacune de ces conversations. Elles relèvent vraiment la barre. Savoir si elles changent votre position juridique dans un scénario précis de divulgation forcée, c’est une question pour vos juristes, pas pour un diagramme d’architecture.
Comment éviter la dépendance à un fournisseur d’IA?
Prévoyez la sortie avant de signer. La dépendance fait plus de dommages à long terme que la résidence, et on en tient compte moins souvent dans les coûts.
Voici comment ça se passe d’habitude. Une équipe bâtit sur le cadre d’agents d’un fournisseur, une base vectorielle exclusive et des prompts optimisés pour une seule famille de modèles. Dix-huit mois plus tard, un meilleur modèle sort ailleurs, les prix changent, ou un régulateur demande une option sur site. Déménager veut dire tout rebâtir.
Rien de ce qui suit ne ralentit le développement. Le sauter rend la sortie coûteuse.
- Les données sources restent dans des formats que vous contrôlez. Gardez la copie de référence dans votre propre stockage, en formats ouverts comme Parquet ou les tables Iceberg. L’index géré d’un fournisseur peut être une copie dérivée, jamais la seule.
- Une passerelle de modèles légère. Faites passer les appels aux modèles par une seule interface interne. Elle vous permet de changer de modèle, d’en faire rouler deux côte à côte sur le même jeu d’évaluation et d’appliquer la règle d’acheminement hybride décrite plus haut.
- Votre propriété intellectuelle vit dans votre dépôt. Les prompts, la configuration de récupération, les jeux d’évaluation, les règles de garde-fous et les données d’ajustement sont versionnés dans votre Git et revus comme du code.
- L’intégration passe par des contrats documentés. Le système d’IA communique avec vos systèmes centraux par des API que vous possédez et pouvez documenter, pas par des connecteurs point à point qu’un seul fournisseur comprend.
- Un plan de sortie d’une page. Ce qui se déplace, ce qui se rebâtit, quels contrats ont des délais de préavis, et une estimation approximative de l’effort. Écrivez-le avant de signer et révisez-le chaque année.
Si vous bâtissez des agents, la même discipline s’applique aux définitions d’outils et aux permissions. On couvre cet aspect dans l’architecture des agents IA en production.
Que doit couvrir une revue d’architecture IA?
Cinq questions par charge de travail : données, emplacement, juridiction, propriété et intégration. Elle tient sur une page et prend une séance de travail, pas un trimestre. C’est la revue qu’on mène avec nos clients.
- Données. Quelles données la charge de travail touche-t-elle à chaque étape : entrée, récupération, prompt, résultat, journaux? De quel palier relève-t-elle?
- Emplacement. Pour chaque modèle d’hébergement envisagé, où chacune de ces étapes est-elle traitée et stockée?
- Juridiction. Quels régimes juridiques pourraient atteindre chaque composant, sous-traitants compris? Quelle est la position documentée, et qui la signe?
- Propriété. Si vous quittez le fournisseur, que gardez-vous et que devez-vous rebâtir? Le plan de sortie est-il écrit?
- Intégration. Quels systèmes internes lit-elle et met-elle à jour, par quelles interfaces et avec quelles permissions?
Le résultat est une courte comparaison de deux ou trois modèles selon ces cinq questions, un modèle recommandé et le nom de la personne imputable de la décision de risque. Cette dernière ligne est ce qui fait repartir un projet en attente.
Pour les contrôles de gouvernance dans le produit lui-même (pistes d’audit, tests de biais, explicabilité), voyez la gouvernance de l’IA pour les équipes produit.
À quoi ressemble une revue de souveraineté pour un assureur québécois?
Voici un exemple illustratif. Il montre la structure d’une revue, pas un vrai mandat client.
La charge de travail. Un assureur de dommages dont le siège social est au Québec veut un assistant qui résume les dossiers de réclamation pour les experts en sinistres : notes des experts, documents de police, photos légendées et correspondance.
Où ça bloquait. Le projet pilote tournait sur une API de modèle de pointe avec les paramètres par défaut. La sécurité a découvert que les prompts et les résultats étaient traités hors du Canada et conservés un certain temps pour la détection des abus. Les juristes ont signalé une évaluation selon la Loi 25 qui n’avait pas été faite. Le projet est resté en suspens deux mois.
La revue.
- Données : palier 2, proche du palier 3. Renseignements personnels recueillis au Québec, dont certains liés à la santé dans les réclamations pour blessures.
- Modèles comparés : A (région canadienne d’un hyperscaler avec un modèle servi dans la région), C (nuage détenu par des intérêts canadiens avec un modèle à poids ouverts) et E (hybride).
- Choix : E. Les dossiers de réclamation et les résumés restent dans une région canadienne avec un modèle dans la région. Une charge de travail distincte, sans renseignements personnels (rédiger des textes génériques qui expliquent les polices), utilise une API de modèle de pointe.
- Conception de la sortie : les données de réclamation restent dans le stockage de l’assureur, les prompts et les jeux d’évaluation vivent dans son dépôt, et une passerelle de modèles se place devant les deux chemins.
- Paperasse : EFVP selon la Loi 25 réalisée pour le sous-traitant dans la région, position sur la juridiction signée par le CISO, plan de sortie revu par l’approvisionnement.
Le résultat. La décision d’architecture a pris deux séances de travail. Le projet est passé de l’attente au développement, avec un responsable nommé et une position documentée.
Qui doit participer à une revue de souveraineté IA?
Quatre personnes : le dirigeant imputable du risque (généralement le CISO ou le DSI), quelqu’un qui connaît les flux de données, quelqu’un qui peut parler d’approvisionnement et de contrats, et un ingénieur qui a déployé des systèmes d’IA selon chacun des modèles d’hébergement que vous comparez.
C’est généralement ce dernier rôle qui manque. La plupart des équipes d’infrastructure connaissent leur nuage. Moins nombreuses sont celles qui ont mis en production des passerelles de modèles, de l’inférence dans la région et de l’acheminement hybride, puis qui les ont exploités par la suite.
C’est là qu’on intervient. Chrono bâtit et exploite des systèmes d’IA avec une équipe de livraison canadienne, et on commence par la revue d’architecture, pour que les décisions de propriété, d’hébergement et d’intégration soient prises avant de bâtir quoi que ce soit.
Questions fréquentes
La LPRPDE exige-t-elle que les données d’IA restent au Canada?
Non. La LPRPDE permet de transférer des renseignements personnels à des sous-traitants hors du Canada, mais vous en restez responsable et devez assurer une protection comparable par contrat ou autrement. La Loi 25 du Québec est plus stricte : elle exige une évaluation des facteurs relatifs à la vie privée avant que des renseignements personnels recueillis au Québec sortent de la province.
Héberger l’IA dans une région infonuagique canadienne protège-t-il les données du CLOUD Act américain?
Pas entièrement. Le CLOUD Act peut obliger les fournisseurs américains à produire les données qu’ils contrôlent, peu importe où elles sont stockées. Une région canadienne règle donc la résidence, mais pas la juridiction. Faites documenter votre position par vos juristes pour les charges de travail à conséquences élevées.
Quelle est la façon la plus simple de réduire la dépendance à un fournisseur d’IA?
Faites passer chaque appel de modèle par une passerelle interne légère, et gardez les prompts, les jeux d’évaluation et les données sources dans votre propre dépôt et votre propre stockage. Vous pourrez ainsi changer de modèle ou de fournisseur sans rebâtir le système.
Quelle charge de travail IA avez-vous mise de côté?
Pas besoin d’une stratégie nationale de souveraineté pour débloquer votre programme d’IA. Il vous faut une charge de travail, revue honnêtement, avec un responsable nommé et un choix documenté.
Dites-nous quelle charge de travail vous avez mise de côté à cause de la résidence, de la dépendance à un fournisseur ou du risque d’intégration, et on fera une revue d’architecture qui compare côte à côte les options de propriété, d’hébergement et d’intégration. Vous gardez la comparaison, qu’on travaille ensemble ou non. Demandez une revue d’architecture.
Cet article présente de l’information générale sur des lois publiques et des engagements de fournisseurs en date d’octobre 2026. Ce n’est pas un avis juridique. Faites examiner votre situation par vos conseillers juridiques.