Point clé
Les données rapportent au moment d'une décision, pas sur un tableau de bord. Choisissez une décision fréquente, branchez-la sur une source à laquelle son responsable fait déjà confiance, livrez le signal dans l'outil où il travaille et vérifiez un seul chiffre à 60 jours.
La plupart des entreprises ont plus de données que de valeur. Cet article s’adresse aux dirigeants qui ont financé un programme de données et qui ne peuvent pas encore dire ce qu’il a rapporté. La solution est petite, et c’est voulu : une décision, une source fiable et un chiffre à vérifier dans 60 jours.
L’entrepôt de données est en place. Les pipelines roulent chaque nuit. Chaque équipe a ses tableaux de bord, et l’équipe de données est occupée depuis deux ans. Puis, en réunion de direction, quelqu’un pose une question simple : quelle décision est devenue plus rapide grâce à tout ça, et qu’est-ce que ça nous a rapporté?
Silence. Personne ne doute que le programme de données a fait du vrai travail. Mais personne ne peut tracer une ligne droite entre ce travail et les revenus, les coûts ou la vitesse.
Les recherches d’IDC pour sa série AI & Data Summit 2026 arrivent au même constat. La qualité, l’intégration et l’accessibilité des données restent les principaux freins pour tirer de la valeur de l’IA. Les données existent. Elles n’arrivent simplement pas là où les décisions se prennent, sous une forme assez fiable pour qu’on agisse.
Pourquoi les programmes de données calent-ils avant de rapporter?
Parce qu’on les mesure à la couverture plutôt qu’aux décisions. Le nombre de sources ingérées, de tables modélisées et de tableaux de bord livrés sont des jalons techniques valables, mais aucun ne dit si quelque chose a changé dans l’entreprise.
La valeur apparaît au moment d’une décision. Un prix est approuvé. Un renouvellement est sauvé. Une livraison est réacheminée. Quelqu’un, ou quelque chose, agit autrement grâce aux données, et un résultat mesurable suit.
Entre le tableau de bord et cette décision, il y a un dernier kilomètre qui n’appartient généralement à personne. L’équipe de données possède le pipeline. L’équipe d’affaires possède la décision. Le travail qui les relie tombe entre les deux :
- Choisir la source fiable quand trois systèmes se contredisent
- Amener le signal dans l’outil où la personne travaille vraiment, pas dans un onglet BI à part
- Définir l’action que les données doivent déclencher
- Noter ce qui s’est passé ensuite, pour que n’importe qui puisse savoir si ça a marché
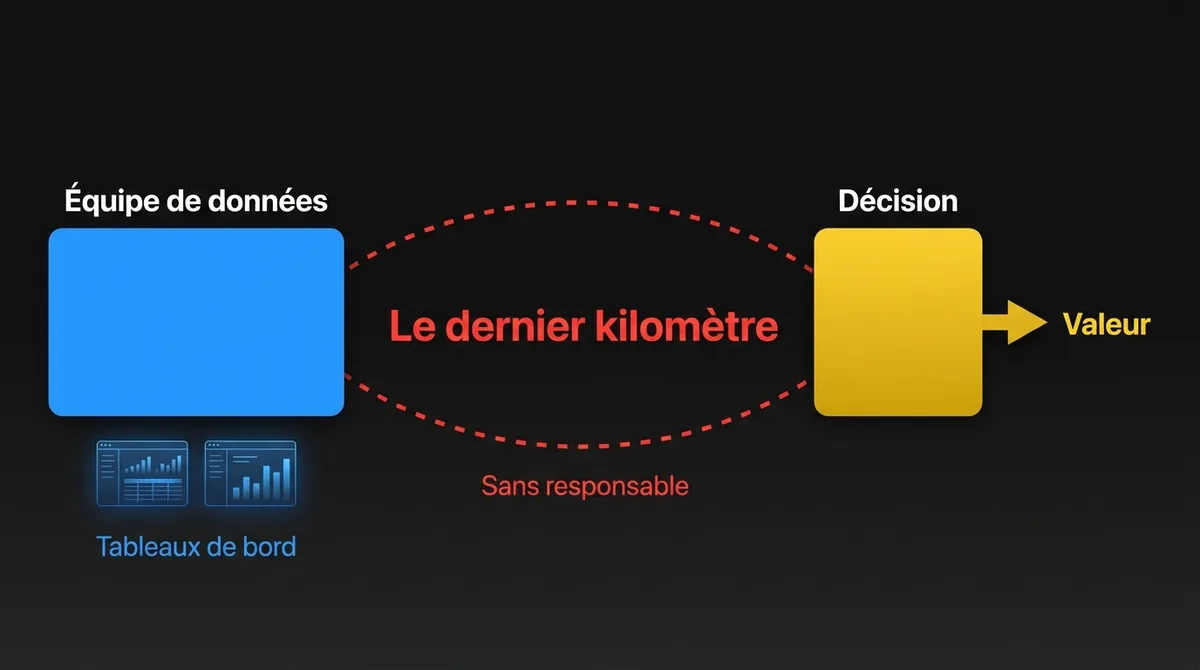
Quand personne ne s’en charge, ce travail ne se fait pas. Les tableaux de bord continuent de se rafraîchir. La décision, elle, continue de reposer sur un chiffrier et sur la mémoire de quelqu’un.
Comment savoir si vos données n’atteignent pas les décisions?
Cherchez les décisions qui dépendent encore d’assemblages manuels, de rapports ouverts au mauvais moment ou de la boîte courriel d’un analyste. On voit une version de ces quatre signes dans presque toutes les entreprises avec qui on travaille. S’ils vous disent quelque chose, vos données sont probablement correctes. C’est le dernier kilomètre qui coince.
Les chiffriers rapiécés. Chaque semaine, quelqu’un exporte le CRM, le système de facturation et la base de données produit, les joint à la main et envoie le résultat à la personne qui décide. L’équipe de données ignore peut-être que ce chiffrier existe.
Les rapports que personne n’ouvre au bon moment. Le risque de désabonnement est dans un rapport BI. Le gestionnaire de compte a son appel de renouvellement jeudi. Ces deux faits ne se croisent jamais.
Les décisions qui attendent une extraction de données. Les décisions d’inventaire, de prix ou de dotation glissent de plusieurs jours parce que la personne qui décide doit demander les chiffres à un analyste.
Les indicateurs sans responsable. Le tableau de bord montre un chiffre qui bouge. Le travail de personne ne dépend du fait d’agir là-dessus, alors personne n’agit.
Chacun de ces cas est une décision prise sur des données fragmentées. Chacun est aussi un problème circonscrit, qu’on peut régler.
Faut-il d’abord corriger les données ou choisir une décision?
Choisissez d’abord la décision. Tout nettoyer et unifier le modèle avant de bâtir le moindre cas d’usage, c’est la raison pour laquelle tant de programmes de données en sont à deux ans sans rien à montrer au chef des finances. Commencez par un inventaire des décisions et corrigez seulement les données dont chacune a besoin.
Dressez la liste des décisions récurrentes d’un secteur de l’entreprise : exceptions de prix, priorisation des renouvellements, approbations de crédit, planification de la capacité, attribution des pistes. Notez chacune selon trois facteurs.
| Facteur | Question | Pourquoi c’est important |
|---|---|---|
| Fréquence | À quelle fréquence cette décision est-elle prise? | Les décisions quotidiennes ou hebdomadaires s’additionnent. Une décision trimestrielle justifie rarement le projet. |
| Valeur par décision | Qu’est-ce qui est en jeu à chaque fois, en dollars ou en heures? | Ça plafonne ce que l’amélioration peut valoir. |
| Maturité des données | Existe-t-il au moins une source à laquelle le responsable fait déjà confiance? | Si toutes les sources sont contestées, vous avez un projet de qualité des données, pas une victoire en 60 jours. |
Le meilleur premier candidat est fréquent, a une vraie valeur et repose sur au moins une source fiable. C’est rarement la décision la plus stratégique de l’entreprise. Ce n’est pas grave. Le premier projet sert à prouver que la méthode fonctionne et à obtenir le budget du deuxième.
Que contient un canevas données-valeur?
Sept champs, sur une page, remplis avant qu’une seule ligne de code soit écrite. On l’appelle le canevas données-valeur :
- Décision. Énoncée simplement. « Quels comptes reçoivent un appel proactif avant le renouvellement. »
- Responsable. La personne imputable du résultat, nommément. Si vous ne pouvez nommer personne, arrêtez ici.
- Intrants actuels. D’où vient l’information aujourd’hui, chiffriers compris.
- Source fiable. Le seul système que le responsable accepte comme vérité pour cette décision.
- Action. Ce qui change quand le signal se déclenche. Une tâche est créée, une approbation est acheminée, un prix est suggéré.
- Indicateur. Le chiffre qui dira si ça a marché, avec une valeur de référence mesurée avant de commencer.
- Premier jalon. Ce qui est livré dans les 30 premiers jours.
Le canevas fait deux choses. Il met les volets affaires et technique dans la même conversation, là où les désaccords cachés finissent par sortir. Et il donne à la direction quelque chose à approuver : un résultat précis, un coût et une date.
Que comprend concrètement un flux de travail données-valeur?
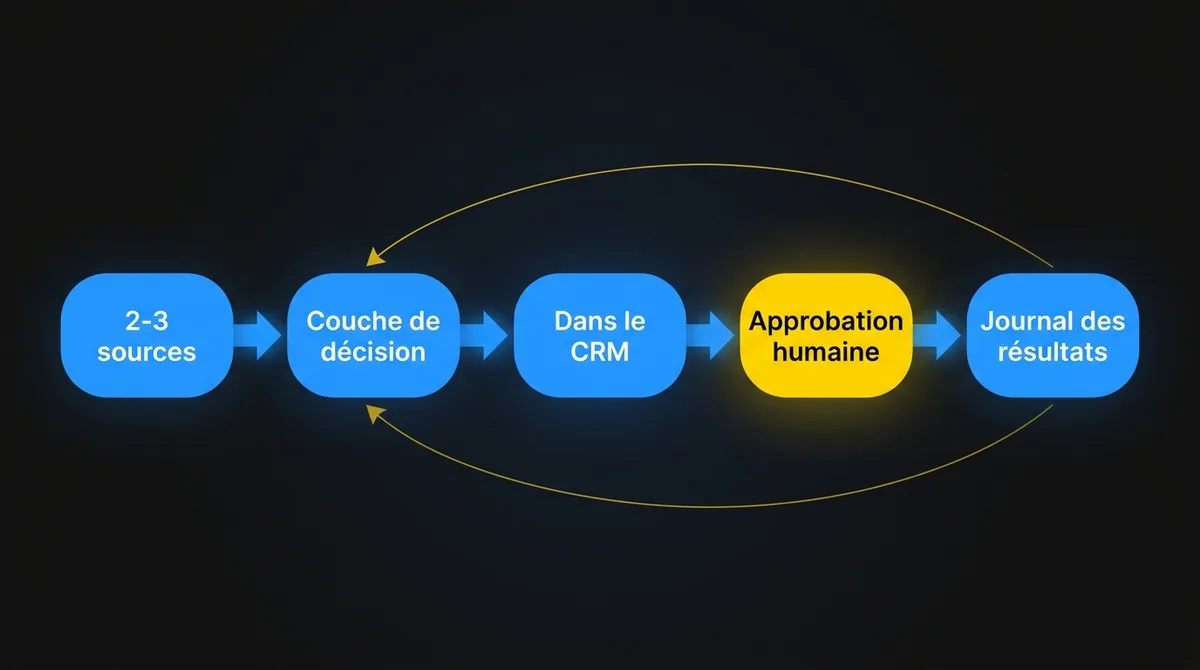
Cinq composantes, et c’est généralement plus restreint qu’on pense. Il faut une ingestion depuis deux ou trois sources, une couche de décision, une livraison dans l’outil où la décision se prend, une étape d’approbation humaine et un journal des résultats. Rien de tout ça n’exige une nouvelle plateforme.
Une ingestion depuis deux ou trois sources. Pas tout l’entrepôt. Allez chercher seulement les champs dont la décision a besoin, dans les systèmes inscrits au canevas. Si un modèle existe déjà dans votre entrepôt, utilisez-le.
Une couche de décision. C’est là que vit la logique. Elle commence souvent par des règles simples que le responsable peut lire et contester. Ajoutez un modèle prédictif ou un LLM (grand modèle de langage) là où il bat clairement les règles, par exemple pour évaluer un risque à partir de plusieurs signaux faibles ou résumer des billets de soutien et des notes d’appel. Versionnez-la et testez-la comme n’importe quel autre service.
Une livraison dans l’outil où la décision se prend. Le signal doit apparaître dans la fiche CRM, la file d’approbation, le canal Slack ou l’écran de l’ERP. Un tableau de bord séparé, c’est un onglet de plus que personne n’ouvre. Si les gens doivent aller chercher l’information, l’adoption chute vite.
Un humain dans la boucle, au début. Le système recommande et une personne approuve. Ça bâtit la confiance et ça produit des données étiquetées sur les moments où la recommandation était juste. Élargissez l’automatisation une fois que le taux d’approbation est élevé et stable.
Un journal des résultats. Consignez chaque recommandation, ce que la personne a fait et ce qui s’est passé ensuite. La plupart des équipes sautent cette étape. C’est pourtant la seule façon de répondre à la question de la direction avec des preuves.
Ce qu’il faut, par contre, ce sont des ingénieurs capables de travailler à la fois dans votre pile de données et dans votre couche applicative, et un responsable de la décision présent chaque semaine.
À quoi ça ressemble pour le risque de renouvellement dans une entreprise SaaS?
Une liste hebdomadaire priorisée des comptes à risque, directement dans le CRM, avec une raison d’une ligne à côté de chaque nom. Les chiffres ci-dessous sont illustratifs, mais la structure s’applique à la plupart des décisions récurrentes.
La décision : quels comptes l’équipe de succès client contacte de façon proactive dans les 90 jours précédant le renouvellement.
Aujourd’hui : les gestionnaires de compte consultent un tableau de bord de désabonnement quand ils y pensent. Le vrai signal est éparpillé. L’utilisation du produit est dans l’outil analytique, les escalades de soutien dans le centre d’assistance, les problèmes de facturation dans le système financier. La plupart des comptes à risque sont repérés pendant l’appel de renouvellement lui-même, quand il est trop tard.
Le canevas :
- Responsable : vice-présidence Succès client
- Sources fiables : événements d’utilisation du produit, billets du centre d’assistance, statut de facturation
- Action : une liste hebdomadaire priorisée dans le CRM, avec une courte raison pour chaque compte (« utilisation en baisse de 40 % sur 6 semaines, deux escalades ouvertes »)
- Indicateur : rétention brute des revenus sur les comptes signalés, comparée à une valeur de référence
- Premier jalon : liste de risque en ligne dans le CRM pour un segment d’ici 30 jours
Le calcul : disons que l’entreprise a 20 M$ en revenus récurrents annuels (ARR), que 8 M$ arrivent à renouvellement sur un semestre et que la rétention brute de cette cohorte est de 88 %. Ça fait 960 k$ perdus. Si une intervention plus hâtive en sauve le cinquième, c’est environ 190 k$ conservés en six mois, grâce à un flux bâti sur des données que l’entreprise avait déjà.
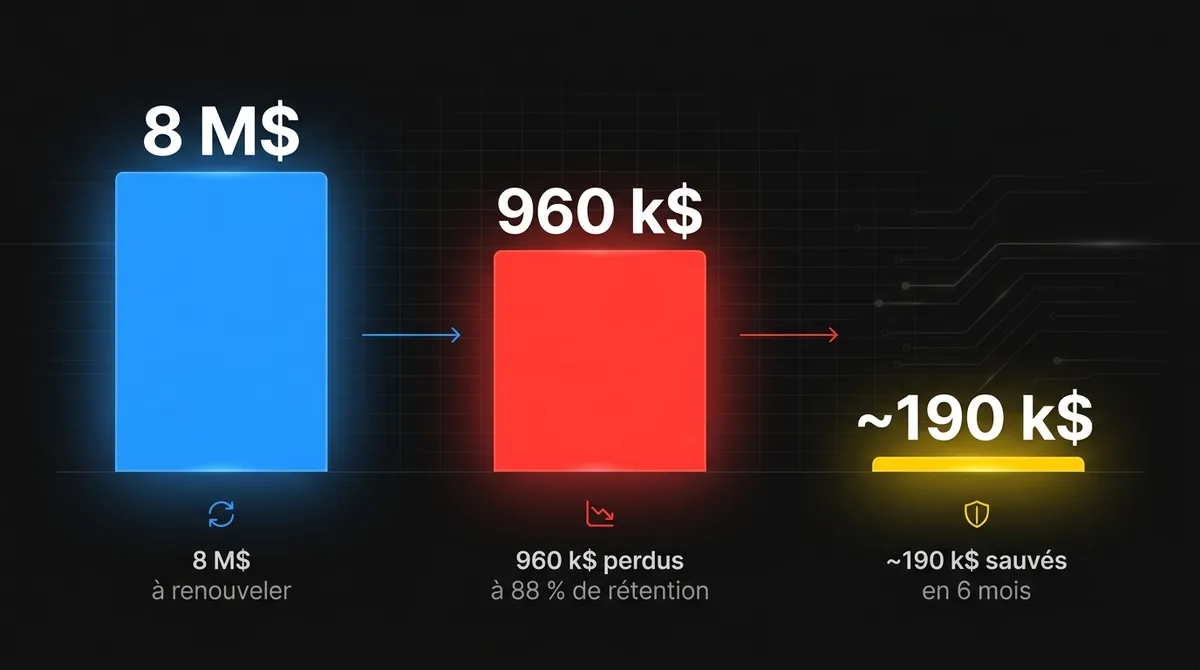
Le modèle est rarement la partie difficile. Le plus dur, c’est de s’entendre sur les événements d’utilisation qui comptent comme de l’engagement, de joindre les données du centre d’assistance aux bons identifiants de compte et d’amener les gestionnaires de compte à travailler à partir de la liste. C’est du travail de dernier kilomètre, et c’est là que se trouve la valeur.
Pour présenter ce genre de calcul à un chef des finances, voyez comment bâtir un dossier d’investissement en IA.
Comment mesurer si un projet de données a fonctionné?
Prenez une valeur de référence avant de livrer, suivez un indicateur avancé et un indicateur retardé, et fixez un point de contrôle à 60 jours avec une décision à la clé. C’est la mesure qui distingue un projet données-valeur d’une autre initiative analytique.
Une valeur de référence avant de livrer. Si vous ne connaissez pas aujourd’hui votre taux de rétention, votre délai d’approbation ou votre erreur de prévision, vous ne pourrez pas revendiquer d’amélioration plus tard. Mesurez-la dès la première semaine.
Un indicateur avancé et un indicateur retardé. La rétention des revenus prend un trimestre à se manifester. L’adoption se voit en quelques jours : quelle part des comptes signalés a été contactée, et à quelle vitesse. Si l’adoption est faible, le résultat ne bougera pas, et vous le saurez tôt.
Un point de contrôle à 60 jours avec une vraie décision à la clé. À 60 jours, vous étendez au segment suivant, vous ajustez la logique ou vous arrêtez. Écrivez d’avance quel résultat déclenche quelle option.
Pour distinguer les indicateurs utiles de ceux qui font juste bien paraître, voyez les KPI des fonctionnalités IA qui disent vraiment quelque chose.
Quelle est la place de l’IA pour transformer les données en décisions?
Dans la couche de décision, une fois les données fiables. Les LLM peuvent lire des billets de soutien, des notes d’appel et des clauses de contrat que les modèles de notation ignoraient. Des agents peuvent exécuter l’action au lieu de seulement la recommander.
Mais l’IA amplifie tout ce qu’on lui donne. Un agent qui travaille sur des données douteuses ne se trompe pas en silence. Il envoie le mauvais courriel, applique le mauvais rabais ou réachemine la mauvaise commande, à grande échelle. L’ordre compte donc : source fiable d’abord, recommandations approuvées par un humain ensuite, automatisation quand l’historique prouve que ça marche.
Les entreprises qui sautent directement aux agents sur des données fragmentées obtiennent de belles démos et un projet pilote qui n’atteint jamais la production. On a décrit ce scénario dans la stratégie IA pour les scale-ups : passer du pilote à la production.
Qui doit participer à un projet données-valeur?
Trois personnes : le responsable de la décision, un ingénieur de données et un ingénieur à l’esprit produit. C’est moins que la plupart des initiatives de données, mais chacune doit être la bonne.
- Le responsable de la décision, chaque semaine. Pas un délégué. Il définit ce qui est « fiable », approuve l’action et pousse l’adoption dans son équipe.
- Un ingénieur de données qui connaît vos sources et peut garder les bons champs joints et à jour.
- Un ingénieur à l’esprit produit qui peut bâtir la couche de décision et l’intégrer aux outils que les gens utilisent déjà.
La plupart des entreprises ont le responsable de la décision et une certaine capacité en ingénierie de données. Le manque se situe généralement au troisième rôle : quelqu’un qui travaille à la fois dans la pile de données et la couche applicative, et qui traite le flux comme un produit plutôt que comme un rapport. C’est le rôle qu’on remplit. Nos ingénieurs s’intègrent à votre équipe, travaillent dans votre pile et mettent le premier flux en production avec vos gens, pour que la capacité reste en place après notre départ.
Questions fréquentes
Combien de temps faut-il pour voir le rendement d’un projet de données?
Un projet centré sur une seule décision devrait montrer de l’adoption en quelques semaines et un résultat mesurable au point de contrôle de 60 jours. Les indicateurs retardés comme la rétention des revenus peuvent prendre un trimestre complet, d’où l’importance de suivre un indicateur avancé en parallèle.
Faut-il un entrepôt de données avant de commencer?
Non. Le premier flux va chercher seulement les champs dont une décision a besoin, dans deux ou trois systèmes. Si un modèle de votre entrepôt couvre déjà ces champs, utilisez-le. Sinon, un pipeline ciblé suffit.
Faut-il des agents IA ou des règles pour la couche de décision?
Commencez par des règles que le responsable peut lire et contester. Ajoutez un modèle prédictif ou un LLM là où il bat clairement les règles, et automatisez l’action seulement quand les taux d’approbation humaine sont élevés et stables.
Par quelle décision commencer?
Celle que votre équipe prend chaque semaine avec des données fragmentées. Pas besoin d’une nouvelle stratégie de données pour tirer de la valeur des données que vous avez déjà. Il faut une décision, cartographiée honnêtement, branchée sur une source à laquelle le responsable fait confiance, avec un chiffre à vérifier dans 60 jours.
Si vous voulez de l’aide pour la cartographier, on offre des séances données-valeur de 20 minutes. On examine une décision, les données derrière et ce qui change si ça fonctionne. Vous repartez avec un premier jalon proposé. Réservez une séance données-valeur.