Point clé
En contexte réglementé, un système d'IA doit être observable avant d'avoir le droit d'être autonome. Consignez pour chaque décision ce qu'il a consulté, décidé, modifié et escaladé, puis servez-vous de ce dossier pour le faire monter d'un échelon d'autonomie à la fois.
Dans les secteurs réglementés, l’automatisation par l’IA ne va qu’aussi loin qu’on peut prouver le contrôle. Cet article s’adresse aux responsables des produits, de l’ingénierie et des risques dans les banques, les assureurs et les fournisseurs qui leur vendent. Il couvre ce que doit contenir un dossier de preuve par décision, comment s’en servir pour gagner de l’autonomie étape par étape, et une grille pour évaluer un flux de travail.
Imaginez la demande de l’audit interne. Prenez n’importe quel mardi du dernier trimestre, n’importe quel client. Montrez-nous ce que votre système d’IA a fait pour ce client : quelles données il a consultées, ce qu’il a conclu, ce qu’il a modifié, et si une personne a eu la chance de l’arrêter.
La plupart des équipes qui font tourner de l’IA en production pourraient montrer que le système était en ligne. Plusieurs pourraient montrer la latence, les taux d’erreur et le coût des jetons. Beaucoup moins pourraient répondre à la question de l’auditeur pour un seul dossier, rapidement et avec assurance.
Cet écart décide jusqu’où va l’automatisation dans les entreprises réglementées. Les dirigeants veulent que l’IA prenne en charge plus de décisions. Leurs fonctions de gestion des risques veulent une preuve de contrôle. Sans cette preuve, le système reste en mode « recommandation seulement » pour toujours, et le dossier d’affaires fondé sur l’automatisation ne rapporte jamais.
Notre position : en contexte réglementé, un système doit être observable avant d’avoir le droit d’être autonome. L’observabilité, ici, veut dire quelque chose de plus précis que des tableaux de bord d’ingénierie. Elle veut dire une preuve, consignée décision par décision, qu’un responsable des risques ou un auditeur peut lire.
Quelle est la différence entre l’observabilité opérationnelle et l’observabilité de la preuve?
L’observabilité opérationnelle dit aux ingénieurs si le système fonctionne. L’observabilité de la preuve dit aux équipes de risque et d’audit ce qu’il a fait pour un client, pourquoi, et qui aurait pu intervenir. L’automatisation réglementée a besoin des deux.
On a déjà écrit sur l’observabilité des agents IA du point de vue de l’ingénierie : tracer les appels d’outils, repérer la dérive des hallucinations et les boucles d’appels d’outils, alerter avant que les utilisateurs remarquent quoi que ce soit. Ce travail garde le système en santé. La deuxième couche répond à une autre question, pour un autre public, avec une autre unité d’analyse.
| Observabilité opérationnelle | Observabilité de la preuve | |
|---|---|---|
| Public | Ingénieurs, personnes de garde | Risques, conformité, audit, régulateurs |
| Unité | Requêtes, segments de trace, métriques | Décisions individuelles sur un client, un compte ou un dossier |
| Question | Est-il en santé et performant? | Qu’a-t-il fait, pourquoi, et qui pouvait intervenir? |
| Conservation | Quelques jours à quelques semaines pour les traces complètes | Aussi longtemps que l’exigent vos obligations de tenue de dossiers |
| Une défaillance ressemble à | Pic de latence, taux d’erreur, dérive | Une décision qu’on ne peut ni reconstituer ni expliquer |
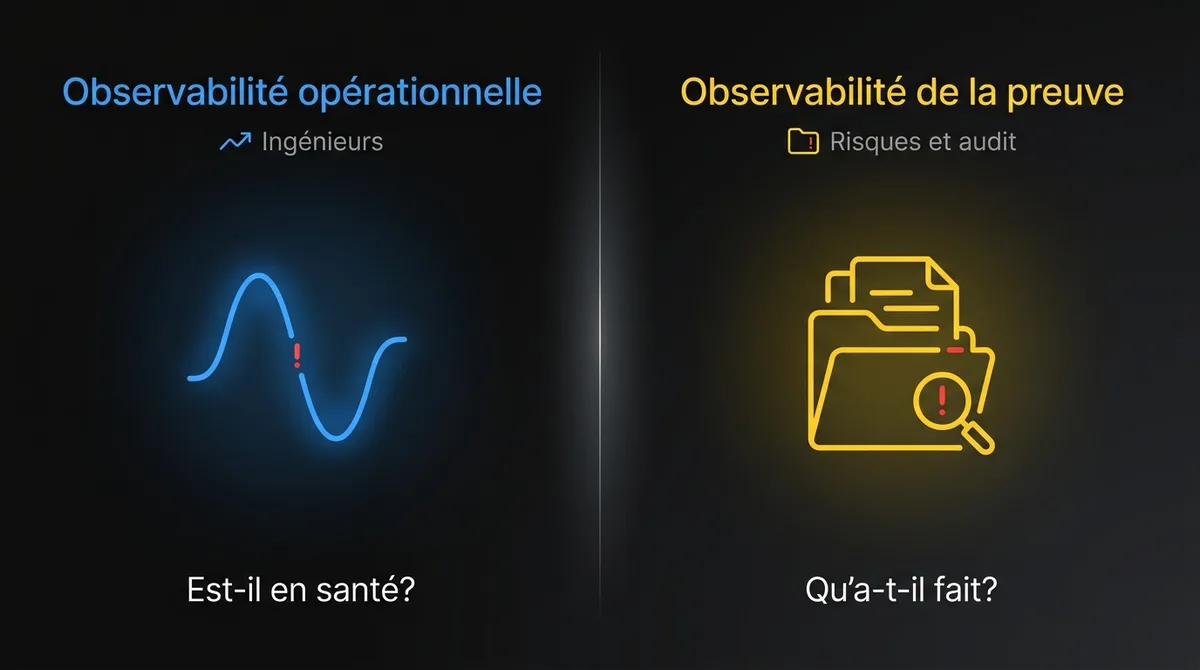
Les deux partagent la même tuyauterie. Les données de trace que vous collectez déjà sont la matière première. Ce qui manque d’habitude, c’est la structure qui transforme ces traces en un dossier de décision lisible par quelqu’un qui n’est pas ingénieur.
Pourquoi la ligne directrice E-23 du BSIF compte-t-elle pour l’IA dans les services financiers canadiens?
Parce qu’elle fait clairement entrer les systèmes d’IA et d’apprentissage automatique dans la gestion du risque de modèle des institutions financières fédérales, et qu’elle entre en vigueur le 1er mai 2027. Le BSIF (Bureau du surintendant des institutions financières) a publié la version finale de la ligne directrice E-23 sur la gestion du risque de modèle en septembre 2025. Elle s’applique aux institutions financières fédérales, dont les banques et les assureurs.
Les commentaires sur la version finale soulignent une définition large du mot « modèle » et des attentes en matière de gouvernance, de contrôles sur le cycle de vie, de surveillance et de supervision des tiers. Ceci n’est pas un avis juridique, et chaque institution interprétera la ligne directrice avec sa propre équipe de risque de modèle. La conséquence pratique reste claire : les systèmes d’IA qui prennent ou orientent des décisions dans une institution fédérale auront besoin de preuves sur tout leur cycle de vie. Bâtir ces preuves après coup est bien plus difficile que de les consigner dès le premier jour. Les systèmes conçus aujourd’hui seront en service quand la ligne directrice s’appliquera.
La même logique vaut hors du secteur bancaire. Les assureurs, les entreprises de paiement, les fournisseurs de sécurité et quiconque vend de l’IA à ces clients recevront la même question des équipes de risque de leurs clients.
Que doit contenir un dossier de décision d’IA?
Il doit répondre seul à quatre questions, sans que personne ait à interroger un ingénieur : ce que le système a consulté, ce qu’il a décidé, ce qu’il a modifié et ce qu’il a escaladé.
Qu’a-t-il consulté? Les sources de données que le système a lues pour ce dossier, avec leurs versions ou leur horodatage. Quels dossiers clients, quels documents, quelles recherches externes. S’il y a eu de la récupération d’information, quels passages ont servi.
Qu’a-t-il décidé? Le résultat, la raison en langage clair, le niveau de confiance ou le score s’il y en a un, et les versions exactes du modèle, de l’invite et des règles d’affaires en vigueur à ce moment.
Qu’a-t-il modifié? Chaque action qui a un effet : dossiers mis à jour, messages envoyés, dossiers fermés, paiements mis en file. Idéalement avec les valeurs avant et après, pour que le changement soit visible plutôt que sous-entendu.
Qu’a-t-il escaladé? Si le dossier a été transmis à une personne, pourquoi, qui l’a traité et ce qu’elle a fait. Tout aussi important : quand le système n’a pas escaladé, quel seuil ou quelle règle lui a permis de continuer seul.
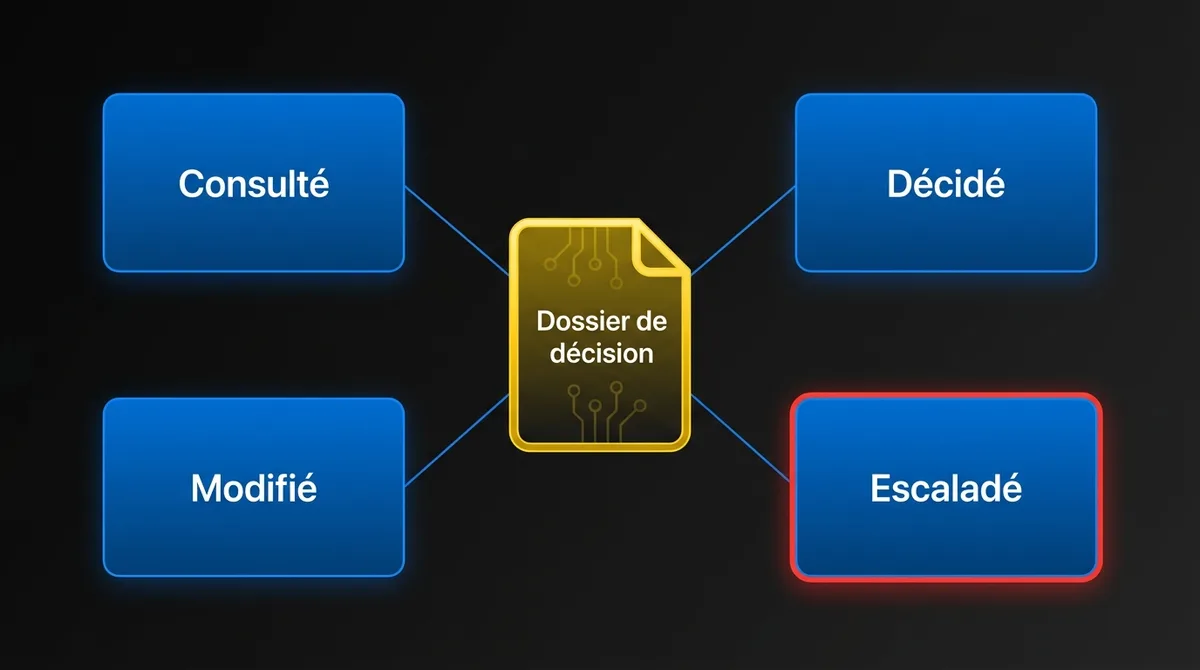
La plupart des systèmes répondent mal à cette quatrième question. Les escalades sont consignées parce qu’une personne y a touché. Les décisions passées directement, celles qui intéressent le plus un auditeur, ne laissent souvent rien d’autre qu’un changement de statut.
À quoi ressemble un dossier de décision en pratique?
Voici une maquette d’un dossier unique pour une alerte de fraude. Les champs comptent plus que le format.
| Champ | Exemple de valeur (illustratif) |
|---|---|
| ID de décision | dec-2026-10-14-004812 |
| Dossier / sujet | Alerte de fraude #A-55120, compte chèques de particulier |
| Horodatage | 2026-10-14 09:42:17 HE |
| Consulté | Historique des transactions (90 jours, en date de 09:41), service d’empreinte d’appareil, alertes antérieures sur le compte (2), journal des contacts client |
| Modèle / invite / règles | triage-model v3.4 · invite tpl-fraud-17 · règles fr-2026-09 |
| Décision | Fermer comme faux positif |
| Raison | Commerçant et montant correspondent à un schéma récurrent sur 14 mois; appareil et lieu conformes aux 30 derniers jours; aucun signalement au journal des contacts |
| Score | 0,94 (seuil de fermeture : 0,90) |
| Modifié | Statut de l’alerte : ouverte → fermée (FP); note ajoutée au dossier |
| Escaladé | Non. Score au-dessus du seuil de fermeture; compte absent de la liste de surveillance; montant sous la limite de révision |
| Révision humaine | Inclus dans l’échantillon d’AQ de 5 % : non |
| Réversible | Oui. Une réouverture dans les 30 jours rétablit l’état de l’alerte |
Un dossier comme celui-ci fait deux choses. Il répond à la question de l’auditeur en une minute. Il rend aussi possible la révision par échantillonnage, parce qu’un réviseur peut vérifier la raison par rapport aux sources sans reconstituer le dossier.
Comment un système d’IA réglementé doit-il gagner plus d’autonomie?
Un échelon à la fois, preuves à l’appui, type de décision par type de décision. L’autonomie ne devrait pas être un interrupteur qu’on actionne au lancement. Une échelle rend les étapes explicites.
| Échelon | Le système… | Preuve nécessaire pour monter |
|---|---|---|
| 0. Observation | Tourne en parallèle du processus humain et consigne ce qu’il aurait fait | Taux d’accord avec les décisions humaines, par segment, sur une période définie |
| 1. Recommandation | Propose; une personne décide de chaque dossier | Taux de dérogation et raisons stables; les réviseurs confirment que les raisons sont exactes |
| 2. Action avec approbation | Prépare l’action; une personne l’approuve avant l’exécution | Taux d’approbation élevé, dérogations expliquées, aucune annulation inexpliquée |
| 3. Action avec révision par échantillon | Agit seul sous des seuils; une personne révise un échantillon et toutes les exceptions | Taux d’erreur de l’échantillon dans la tolérance; logique d’escalade testée |
| 4. Autonomie encadrée | Agit seul à l’intérieur de limites définies; surveillance globale et revue périodique | Rendement soutenu à l’échelon 3; capacité de pause et de retour en arrière testée |
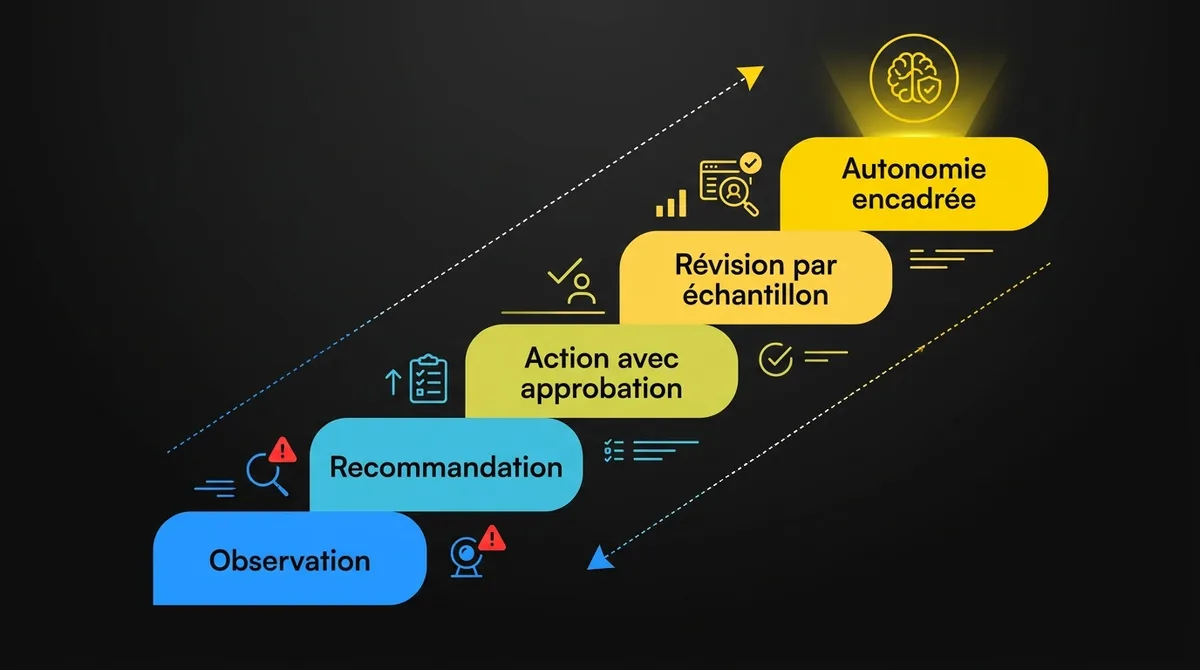
Chaque montée est une décision documentée, avec un approbateur nommé et les preuves en annexe. Chaque descente devrait être tout aussi facile, et se déclencher automatiquement quand la surveillance franchit un seuil. Un système qui ne peut que monter, votre équipe de risque le gardera à l’échelon 1.
L’échelle change aussi la conversation avec le comité des risques. Au lieu de lui demander d’approuver « l’IA », l’entreprise lui demande d’approuver un échelon pour un type de décision, avec les preuves exigées pour l’échelon suivant définies d’avance.
Comment évaluer l’observabilité et le contrôle d’un flux de travail d’IA?
Notez chacun des dix domaines ci-dessous 0 (absent), 1 (partiel) ou 2 (en place), pour un flux de travail automatisé. C’est un point de départ pour discuter avec l’équipe de risque, pas une norme réglementaire.
| Domaine | À quoi ressemble « en place » | Note |
|---|---|---|
| Dossier d’accès | Sources et versions consignées pour chaque décision | 0 / 1 / 2 |
| Dossier de décision | Résultat, raison et versions du modèle, de l’invite et des règles pour chaque décision | 0 / 1 / 2 |
| Dossier de modification | Valeurs avant et après pour chaque effet | 0 / 1 / 2 |
| Dossier d’escalade | Dossiers transmis et non transmis expliqués dans les deux cas | 0 / 1 / 2 |
| Reconstitution | N’importe quelle décision récupérable en quelques minutes par quelqu’un qui n’est pas ingénieur | 0 / 1 / 2 |
| Révision humaine | Échantillonnage et révision des exceptions définis, dotés en personnel et consignés | 0 / 1 / 2 |
| Seuils | Écrits, détenus par l’entreprise, avec historique des changements | 0 / 1 / 2 |
| Pause et retour en arrière | Testés pour chaque type de décision | 0 / 1 / 2 |
| Intégrité | Les dossiers ne peuvent pas être modifiés par le système qui les a produits | 0 / 1 / 2 |
| Conservation | Alignée sur vos obligations de tenue de dossiers | 0 / 1 / 2 |
Un flux qui obtient moins de 10 n’est pas prêt à dépasser l’échelon 1. Entre 10 et 16, les lacunes sont en général précises et réparables. À 17 ou plus, la conversation avec l’équipe de risque peut porter sur le prochain échelon.
À quoi ça ressemble pour le triage des alertes de fraude?
Exemple illustratif, pas un cas client.
L’équipe antifraude d’une banque de taille moyenne traite des milliers d’alertes de transactions par semaine, surtout des faux positifs. L’entreprise veut que l’IA ferme les cas évidents pour que les analystes se concentrent sur la vraie fraude.
Ce qui bloquait. Le projet pilote fermait les alertes avec précision en test, mais une alerte fermée ne laissait qu’un changement de statut dans le système de gestion des dossiers. L’équipe de risque de modèle a demandé comment l’équipe pourrait montrer, pour n’importe quelle alerte fermée, ce que le système avait consulté et pourquoi il n’avait pas escaladé. Personne n’avait de réponse qui n’impliquait pas un ingénieur en train de lire des journaux bruts.
Ce qui a changé.
- Chaque décision écrivait un dossier comme la maquette ci-dessus, dans un registre où le système de triage pouvait ajouter des entrées sans pouvoir les modifier.
- Le système a commencé à l’échelon 0, en observant les analystes pendant une période définie, puis il est passé à l’échelon 1.
- Une fois que l’historique des dérogations l’a justifié, les fermetures sous une limite de valeur sont passées à l’échelon 3 : automatiques, avec un échantillon d’AQ de 5 % et la révision de chaque exception.
- Chaque type d’alerte a reçu un interrupteur de pause, détenu par le responsable des opérations antifraude et testé chaque mois.
Le modèle était la partie facile. Ce qui a mené à l’approbation, c’est le dossier, l’échelle et l’intégration avec le système de gestion des dossiers que les analystes utilisaient déjà.
Pour le volet du responsable d’affaires, mesurer le succès des fonctionnalités IA explique quelles métriques associer à chaque échelon. La base pour la journalisation et le versionnage des modèles se trouve dans notre guide de gouvernance de l’IA pour les équipes produit.
Qui construit l’observabilité de la preuve?
Personne, la plupart du temps, parce qu’elle se trouve entre les équipes. L’ingénierie possède les traces. Les risques possèdent les exigences. Les opérations possèdent le processus de révision. Personne ne possède le dossier de décision qui les relie, alors il n’existe généralement pas.
Nos ingénieurs s’intègrent aux équipes de nos clients pour bâtir des flux d’IA gouvernés où ce dossier est prévu dès la conception. Il est intégré à vos systèmes de gestion des dossiers et à vos systèmes centraux, structuré pour la révision humaine, et vit dans votre code, selon votre cycle de livraison. Votre équipe garde le système et la méthode.
Questions fréquentes
La ligne directrice E-23 du BSIF s’applique-t-elle aux modèles d’IA?
Les commentaires sur la version finale soulignent une définition large du mot « modèle » qui fait clairement entrer les systèmes d’IA et d’apprentissage automatique dans son champ d’application pour les institutions financières fédérales. Elle entre en vigueur le 1er mai 2027. Validez son application à votre institution avec vos conseillers en risque de modèle, en conformité ou juridiques.
Quelle est la différence entre l’observabilité et l’auditabilité de l’IA?
L’observabilité au sens de l’ingénierie suit la santé du système : latence, erreurs, dérive. L’auditabilité exige un dossier par décision, lisible par quelqu’un qui n’est pas ingénieur, qui montre ce que le système a consulté, décidé, modifié et escaladé.
Combien de temps faut-il pour faire passer un système d’IA de la recommandation à l’autonomie?
Il n’y a pas d’échéancier fixe. Chaque échelon exige ses propres preuves, comme des taux de dérogation stables ou un taux d’erreur d’échantillon dans la tolérance, et chaque type de décision avance à son propre rythme.
Quelle décision automatisée examiner en premier?
Choisissez une décision que votre organisation automatise aujourd’hui, ou qu’elle veut automatiser. Cartographiez les preuves et le contrôle qu’elle exige : ce qu’elle consulte, ce qu’elle décide, ce qu’elle modifie et ce qu’elle escalade. Puis évaluez-la.
On mène des revues d’observabilité et de contrôle sur un seul flux de travail. On passe les quatre questions et la grille avec votre équipe, et vous repartez avec une maquette d’audit pour ce flux et la liste des lacunes à combler avant qu’il monte d’un échelon. Réservez une revue.
Cet article est de l’information générale, pas un avis juridique ou réglementaire. Validez l’application de la ligne directrice E-23 du BSIF ou d’autres exigences à votre institution avec vos conseillers en risque de modèle, en conformité ou juridiques.